比较不同CPU下的分支预测
比较不同CPU下的分支预测
目的
本文通过一段对分支预测是否友好的代码来验证 branch load miss 差异,已经最终带来的 性能差异。同时在x86和aarch64 下各选几款CPU共7款进行差异性对比
CPU 情况
CPU 一览表
| CPU | 架构 | 微架构 | 年份 | 制程 | 测试环境核数 | 主频 | L1d | L1i | L2 | L3 |
|---|---|---|---|---|---|---|---|---|---|---|
| Intel 8163 | x86 | Skylake-SP | 2017 | 14nm | 48 (24C×2S) | 2.5GHz | 32K | 32K | 1024K | 33792K |
| Hygon 7260 | x86 | Zen 1 (OEM) | 2019 | 14nm | 48 (24C×2S) | 2.2GHz | 32K | 64K | 512K | 8192K |
| 鲲鹏920 | ARM v8 | TaiShan v110 | 2019 | 7nm | 96 (48C×2S) | 2.6GHz | 64K | 64K | 512K | 24576K |
| ARM M710 | ARM v9 | Neoverse V1 | 2022 | 5nm | 128 (128C×1S) | 2.75GHz | 64K | 64K | 1024K | 65536K |
| FT S2500 | ARM v8 | FTC663 | 2021 | 16nm | 128 (64C×2S) | 2.1GHz | 32K | 32K | 2048K | 65536K |
| Intel 6982P-C | x86 | Granite Rapids | 2024 | Intel 3 | 16 (8C×1S, HT) | 3.8GHz | 48K | 64K | 2048K | 516096K |
| AMD 9T25 | x86 | Zen 5 (Turin) | 2024 | TSMC 3/4nm | 16 (8C×1S, SMT) | 3.8GHz | 48K | 32K | 1024K | 32768K |
后两款 CPU 在阿里云 ECS 第九代机型上测试(ecs.g9i.4xlarge / ecs.g9a.4xlarge),2026-08-31 实测。
Intel 8163 (Skylake-SP, 2017)
1 | #lscpu |
Hygon 7260 (Zen 1 OEM, 2019)
1 | #lscpu |
ARM 鲲鹏920 (TaiShan v110, 2019)
1 | #lscpu |
ARM M710 (Neoverse V1, 2022)
1 | #lscpu |
ARM FT S2500 (FTC663, 2021)
1 | #lscpu |
Intel Xeon 6982P-C (Granite Rapids, 2024)
阿里云 ECS ecs.g9i.4xlarge,16vCPU/64G。实测全核频率 3800MHz。
1 | #lscpu |
AMD EPYC 9T25 (Turin / Zen 5, 2024)
阿里云 ECS ecs.g9a.4xlarge,16vCPU/64G。实测全核频率 ~3804MHz。
1 | #lscpu |
测试代码
对一个数组中较大的一半的值累加:
1 |
|
以上代码可以注释掉第15行,也就是不对代码排序直接累加,不排序的话 if (data[c] >= 128) 有50% 概率成立,排序后前一半元素if都不成立,后一半元素if都成立,导致CPU流水线很好预测后面的代码,可以提前加载运算打高IPC
测试结果
aarch64 鲲鹏920
1 | #perf stat -e branch-misses,bus-cycles,cache-misses,cache-references,cpu-cycles,instructions,stalled-cycles-backend,stalled-cycles-frontend,alignment-faults,bpf-output,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-dcache-store-misses,L1-dcache-stores,L1-icache-load-misses,L1-icache-loads,branch-load-misses,branch-loads,dTLB-load-misses,dTLB-loads,iTLB-load-misses,iTLB-loads ./aftersort |
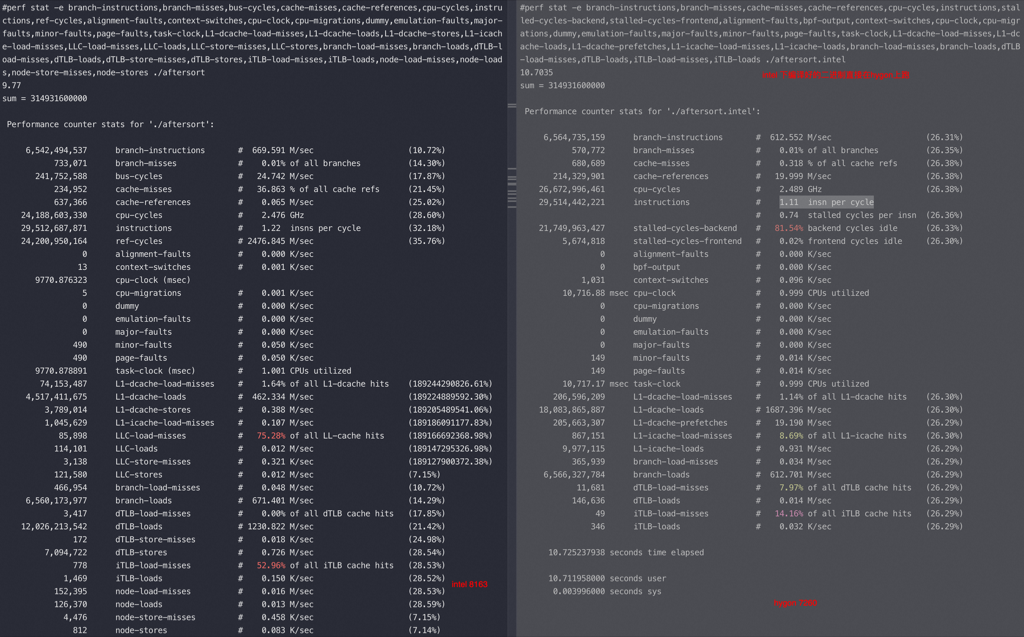
以上在相同CPU下数据对比可以看到核心差异是branch-load-misses和branch-misses,当然最终也体现在 IPC 数值上,排序后IPC更高不是因为数据有序取起来更快,而是因为执行逻辑更容易提前预测,也就是可以提前加载if代码到cache中。符合预期
aarch64 M710
1 | #perf stat -e branch-misses,bus-cycles,cache-misses,cache-references,cpu-cycles,instructions,stalled-cycles-backend,stalled-cycles-frontend,alignment-faults,bpf-output,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-icache-load-misses,L1-icache-loads,LLC-load-misses,LLC-loads,branch-load-misses,branch-loads,dTLB-load-misses,dTLB-loads,iTLB-load-misses,iTLB-loads ./aftersort |
M710上排序与否和鲲鹏差不多,但是 M710比 鲲鹏要快一些,差别只要有主频高一点点(6%),另外M710编译后的指令数量也略少(8%)。
最大的差别是没有排序的话 branch-load-misses(1,232,325,180)/branch-loads(14,776,289,690) 比例只有鲲鹏的50%,导致整体 IPC 比鲲鹏高不少(1.66 VS 1.04)
如果是排序后的数据来看 M710比鲲鹏好40%,IPC 好了20%,iTLB-loads 差异特别大
aarch64 FT S2500
1 | #perf stat -e branch-misses,bus-cycles,cache-misses,cache-references,cpu-cycles,instructions,alignment-faults,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-dcache-store-misses,L1-dcache-stores,L1-icache-load-misses,L1-icache-loads,branch-load-misses,branch-loads,dTLB-load-misses,iTLB-load-misses ./aftersort |
Intel x86 8163
1 | #perf stat -e branch-instructions,branch-misses,bus-cycles,cache-misses,cache-references,cpu-cycles,instructions,ref-cycles,alignment-faults,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-dcache-stores,L1-icache-load-misses,LLC-load-misses,LLC-loads,LLC-store-misses,LLC-stores,branch-load-misses,branch-loads,dTLB-load-misses,dTLB-loads,dTLB-store-misses,dTLB-stores,iTLB-load-misses,iTLB-loads,node-load-misses,node-loads,node-store-misses,node-stores ./aftersort |
从 x86 和 aarch 对比来看,x86 编译后的指令数是 aarch 的35%,ARM 是精简指令,数量多比较好理解。主频2.5 GHz 较 M710低了11%。
IPC 差异比较大,有一部分是因为 ARM 精简指令本来有较高的 IPC。
从排序前的差异来看除了指令集外导致 IPC 较高的原因主要也是 branch-load-misses(1,232,325,180)/branch-loads(14,776,289,690) 比 intel的 1,602,020,038/6,568,921,480, 也就是 M710的 branch miss 率比 intel 低了一倍。
排序后去掉了 branch miss 差异,M710 比 intel 快了 10%,只要是因为主频的差异
on 8269 3.2GHz
1 | #perf stat -e branch-instructions,branch-misses,cpu-cycles,instructions,branch-load-misses,branch-loads,task-clock,cpu-clock ./beforesort |
hygon 7260
1 | #perf stat -e branch-instructions,branch-misses,cache-misses,cache-references,cpu-cycles,instructions,stalled-cycles-backend,stalled-cycles-frontend,alignment-faults,bpf-output,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-dcache-prefetches,L1-icache-load-misses,L1-icache-loads,branch-load-misses,branch-loads,dTLB-load-misses,dTLB-loads,iTLB-load-misses,iTLB-loads ./aftersort |
hygon 在这两个场景中排序前比 intel 好了 20%,IPC 好30%,但是指令数多了10%,最关键的也是因为hygon的 branch-load-misses 率较低。
排序后 hygon 略慢10%,主要是指令数多了将近10%。
如果直接将 intel 下 编译好的二进制放到 hygon 下运行,完全可以跑通,指令数也显示和 intel 一样了,但是总时间较在hygon下编译的二进制没有变化
Intel Xeon 6982P-C (Granite Rapids, 2024)
阿里云 ECS ecs.g9i.4xlarge,16vCPU/64G,实测全核频率 3800MHz。编译选项 -O0(禁止优化,保留真实分支指令)。
1 | #taskset -c 0 perf stat -e task-clock,cpu-cycles,instructions,branches,branch-misses,cache-references,cache-misses /tmp/aftersort_O0 |
排序后 IPC 2.19,未排序 IPC 跌到 0.68,branch-misses 15.05%。分支 miss 导致耗时增加 3.2 倍(4.18s → 13.48s)。
AMD EPYC 9T25 (Turin / Zen 5, 2024)
阿里云 ECS ecs.g9a.4xlarge,16vCPU/64G,实测全核频率 ~3804MHz。编译选项 -O0。
1 | #taskset -c 0 perf stat -e task-clock,cpu-cycles,instructions,branches,branch-misses,cache-references,cache-misses,L1-dcache-load-misses,L1-dcache-loads,L1-icache-load-misses /tmp/aftersort_O0 |
排序后 IPC 4.46(是 Intel 的 2 倍),未排序 IPC 2.91,branch-misses 仅 1.59%(Intel 的 1/10)。分支 miss 导致耗时仅增加 53%(1.78s → 2.73s),远低于 Intel 的 222%。
Xeon 6982P-C vs EPYC 9T25 对比小结
| 指标 | Intel 6982P-C | AMD 9T25 | 差距 |
|---|---|---|---|
| 排序后耗时 | 4.18s | 1.78s | AMD 快 2.35x |
| 排序后 IPC | 2.19 | 4.46 | AMD 高 104% |
| 排序后 branch-miss | 0.00% | 0.00% | 持平 |
| 未排序耗时 | 13.48s | 2.73s | AMD 快 4.94x |
| 未排序 IPC | 0.68 | 2.91 | AMD 高 328% |
| 未排序 branch-miss | 15.05% | 1.59% | AMD miss 率低 10x |
| 未排序减速比 | 3.2x | 1.5x | Intel 惩罚大 2 倍 |
两层差距:(1) 纯 IPC 差距——即使分支全部可预测,AMD 仍快 2.35 倍(Zen 5 的 8 宽解码 + 4 load 单元 vs Redwood Cove 的 6 宽 + 3 load);(2) 分支预测器准确率——面对 50% 随机分支,AMD 预测器能从 32768 个元素的固定序列中记住每个位置的分支方向(miss 1.59%),Intel 记不住(miss 15.05%)。
测试时间:2026-08-31,阿里云 ECS 第九代 g9i/g9a 机型。
开启 gcc O3 优化
intel 8163
1 | #perf stat -e branch-instructions,branch-misses,bus-cycles,cache-misses,cache-references,cpu-cycles,instructions,ref-cycles,alignment-faults,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-dcache-stores,L1-icache-load-misses,LLC-load-misses,LLC-loads,LLC-store-misses,LLC-stores,branch-load-misses,branch-loads,dTLB-load-misses,dTLB-loads,dTLB-store-misses,dTLB-stores,iTLB-load-misses,iTLB-loads,node-load-misses,node-loads,node-store-misses,node-stores ./beforesort |
可以看到 O3 优化后是否排序执行时间差不多,并且都比没有 O3 前的快几倍,指令数较优化前基本不变。
最明显的是排序前的 branch-load-misses 几乎都被优化掉了,这也导致 IPC 从0.41 提升到了3.59
aarch64 M710
1 | #perf stat -e branch-misses,bus-cycles,cache-misses,cache-references,cpu-cycles,instructions,stalled-cycles-backend,stalled-cycles-frontend,alignment-faults,bpf-output,context-switches,cpu-clock,cpu-migrations,dummy,emulation-faults,major-faults,minor-faults,page-faults,task-clock,L1-dcache-load-misses,L1-dcache-loads,L1-icache-load-misses,L1-icache-loads,LLC-load-misses,LLC-loads,branch-load-misses,branch-loads,dTLB-load-misses,dTLB-loads,iTLB-load-misses,iTLB-loads ./beforesort |
可以看到在M710上开启 O3 优化后是否排序执行时间差不多,并且都比没有 O3 前
的快几倍,最明显的是指令数只有之前的7%。另外就是排序前的 branch-load-misses 几乎都被优化掉了,虽然这里 IPC 提升不大但主要在指令数的减少上。
O3意味着代码尽可能展开,更长的代码意味着对 L1i(以及 L2和更高级别)高速缓存的压力更高。这会导致性能降低。更短的代码可以运行得更快。幸运的是,gcc 有一个优化选项可以指定此项。如果使用-Os,则编译器将优化代码大小。使用后,能够增加代码大小的哪些优化将被禁用。使用此选项通常会产生令人惊讶的结果。特别是循环展开和内联没有实质优势时,那么此选项将是一个很好的选择。
分支预测原理介绍
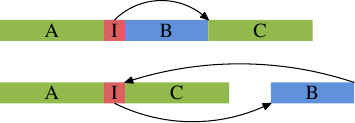
如上图的上面部分代表通常情况下的简单代码布局。如果区域 B(这里是内联函数 inlfct 生成的代码)经常由于条件 I 被跳过,而不会执行,处理器的预取将拉入很少使用的包含块 B 的高速缓存行。使用块重新排序可以改变这种局面,改变之后的效果可以在图的下半部分看到。经常执行的代码在内存中是线性的,而很少执行的代码被移动到不会损害预取和 L1i 效率的位置。
Linux内核流水线优化案例
在Linux Kernel中有大量的 likely/unlikely
1 | //ip 层收到消息后,如果是tcp就调用tcp_v4_rcv作为tcp协议的入口 |
__builtin_expect 这个指令是 gcc 引入的。该函数作用是允许程序员将最有可能执行的分支告诉编译器,来辅助系统进行分支预测。(参见 https://gcc.gnu.org/onlinedocs/gcc/Other-Builtins.html)
它的用法为:__builtin_expect(EXP, N)。意思是:EXP == N的概率很大。那么上面 likely 和 unlikely 这两句的具体含义就是:
- __builtin_expect(!!(x),1) x 为真的可能性更大 //0两次取反还是0,非0两次取反都是1,这样可以适配__builtin_expect(EXP, N)的N,要不N的参数没法传
- __builtin_expect(!!(x),0) x 为假的可能性更大
当正确地使用了__builtin_expect后,编译器在编译过程中会根据程序员的指令,将可能性更大的代码紧跟着前面的代码,从而减少指令跳转带来的性能上的下降。让L1i中加载的代码尽量有效紧凑
这样可以让 CPU流水线分支预测的时候默认走可能性更大的分支。如果分支预测错误所有流水线都要取消重新计算。
如果程序员利用这些宏,然后使用 -freorder-blocks 优化选项,则 gcc 将对块进行重新排序,如原理解图所示。该选项在 -O 2中启用,但在-Os 中禁用。还有另一种对块进行重新排序的选项(-freorder-blocks-and-partition ),但是它的用处有限,因为它不适用于异常处理。
总结
测试方法论
本测试的精妙之处在于:排序后 vs 未排序跑的指令数完全一样(同一段代码、同样多的循环),唯一区别是 if (data[c] >= 128) 的分支结果序列不同。因此:
- 排序后的数据 = 纯 IPC 基准线:branch-miss 率接近 0%,消除了分支预测的干扰,剩下的耗时差异纯粹反映 CPU 流水线宽度和执行效率(解码宽度、执行端口数、load 单元数)
- 未排序的数据 = IPC + 分支预测的综合表现:50% 随机分支考验预测器准确率,miss 后流水线冲刷的惩罚直接体现在 IPC 下降和耗时增加上
- 两者的差值 = 分支预测带来的纯惩罚:同一颗 CPU 排序前后的耗时差就是分支 miss 导致的性能损失
未排序(分支难预测)运行数据对比
| branch-miss 率 | instructions | IPC | 耗时(秒) | 排序后耗时(秒) | 减速比 | |
|---|---|---|---|---|---|---|
| 鲲鹏920 | 21.7% | 83,694,841,472 | 1.04 | 30.92 | 11.44 | 2.7x |
| M710 | 8.3% | 77,083,625,280 | 1.66 | 16.89 | 8.20 | 2.1x |
| Intel 8163 | 24.4% | 29,618,485,912 | 0.41 | 29.52 | 9.77 | 3.0x |
| hygon 7260 | 11.8% | 32,850,416,330 | 0.56 | 23.36 | 10.95 | 2.1x |
| FT S2500 | 24% | 83,872,213,462 | 1.01 | 39.8 | 16.63 | 2.4x |
| Intel 6982P-C | 15.05% | 32,848,735,148 | 0.68 | 13.48 | 4.18 | 3.2x |
| AMD 9T25 | 1.59% | 32,814,347,862 | 2.91 | 2.73 | 1.78 | 1.5x |
排序后(分支可预测)运行数据对比——纯 IPC 基准线
| instructions | instructions(排序前) | IPC | 耗时(秒) | |
|---|---|---|---|---|
| 鲲鹏920 | 83,666,813,837 | 83,694,841,472 | 2.82 | 11.44 |
| M710 | 77,068,271,833 | 77,083,625,280 | 3.42 | 8.20 |
| Intel 8163 | 29,491,804,977 | 29,618,485,912 | 1.22 | 9.77 |
| hygon 7260 | 32,785,270,866 | 32,850,416,330 | 1.20 | 10.95 |
| FT S2500 | 83,918,069,835 | 83,872,213,462 | 2.41 | 16.63 |
| Intel 6982P-C | 32,839,518,267 | 32,848,735,148 | 2.19 | 4.18 |
| AMD 9T25 | 32,831,746,236 | 32,814,347,862 | 4.46 | 1.78 |
关键结论
- 所有 CPU 都期望对分支预测友好的代码
- 分支预测重点关注 perf branch-load-misses/branch-loads
- aarch64 较 x86_64 指令数是2.6倍,同时对流水线更友好,也就是 IPC 更高(2.6倍),测试代码单线程、无锁
- M710的分支预测正确率是鲲鹏920、intel的3倍,hygon 是鲲鹏 、intel的分支预测率的2倍
- AMD 9T25 (Zen 5) 的分支预测准确率是所有 7 款 CPU 中最高的:miss 率仅 1.59%,是 Intel 6982P-C 的 1/10,是老款 Intel 8163 的 1/15
- AMD 9T25 排序后 IPC 4.46 是所有 CPU 中最高的,比 Intel 6982P-C 的 2.19 高出一倍,说明 Zen 5 的 8 宽解码 + 4 load 单元的架构优势在排除分支预测干扰后依然碾压
- 分支 miss 的减速比:Intel 6982P-C 减速 3.2 倍(最严重),AMD 9T25 仅减速 1.5 倍(最轻微)。AMD 受分支 miss 影响最小的原因是预测器足够准确(miss 率低),而非单次 miss 惩罚小(两家的单次 miss penalty 都约 22-25 cycles)
- Intel 从 8163 (Skylake, 2017) 到 6982P-C (Granite Rapids, 2024),7 年间分支 miss 率从 24.4% 降到 15.05%(改善 38%),IPC 从 0.41 提升到 0.68(+66%)。AMD 同期从 hygon 7260 (Zen 1, 2019) 到 9T25 (Zen 5, 2024),miss 率从 11.8% 降到 1.59%(改善 87%),IPC 从 0.56 提升到 2.91(+419%)。AMD 的进化速度远超 Intel
- 10% 的分支load miss 会带来一倍的性能差异
- gcc O3 优化效果很明显,代价就是代码展开后很大,容易造成icache不够,对小段测试代码效果最好,实践不一定
- 测试代码只是极简场景,实际生产环境更复杂,也就是预测效果不会这么明显。但在 MySQL sysbench 点查实测中,AMD 9T25 在 128 线程下比 Intel 6982P-C 快 40%,与本测试揭示的 IPC 和分支预测优势方向一致