plantegg

java tcp mysql performance network docker Linux

关于本博

find me on twitter: @plantegg

Github: 欢迎star

关注基础知识,一次把问题搞清楚,从案例出发深挖相关知识。

以前觉得自己一看就懂,实际是一问就打鼓,一用就糊涂。所以现在开始记录并总结再联系案例,一般是先把零散知识记录下来(看到过),慢慢地相关知识积累更多,直到碰到实践案例或是有点领悟到于是发现这块知识可以整理成一篇系统些的文章(基本快懂了)。

“技术变化太快,容易过时”,我的看法是网络知识、操作系统、计算机原理等核心概念知识的寿命会比你的职业生涯还长。这些都是40岁之后还会还会很有用

如何在工作中学习 所有方法我都记录在这篇文章中了,希望对你能有所帮助。

所有新文章从这里可以看到,即使再简单的一篇总结我可以持续总结三五年,有新的发现、感悟都是直接在原文上增减,不会发表新的文章。

image-20220421102225491

为什么写博客而不是公众号,我见过20年前的互联网,深度依赖搜索引擎,所以还是喜欢博客。另外技术类文章更适合电脑阅读(随时摘录、实验)

精华文章推荐(2021年前)

在2010年前后MySQL、PG、Oracle数据库在使用NUMA的时候碰到了性能问题,流传最广的这篇 MySQL – The MySQL “swap insanity” problem and the effects of the NUMA architecture http://blog.jcole.us/2010/09/28/mysql-swap-insanity-and-the-numa-architecture/ 文章描述了性能问题的原因(文章中把原因找错了)以及解决方案:关闭NUMA。 实际这个原因是kernel实现的一个低级bug,这个Bug在2014年修复了https://github.com/torvalds/linux/commit/4f9b16a64753d0bb607454347036dc997fd03b82,但是修复这么多年后仍然以讹传讹,这篇文章希望正本清源、扭转错误的认识。

image-20210517082233798

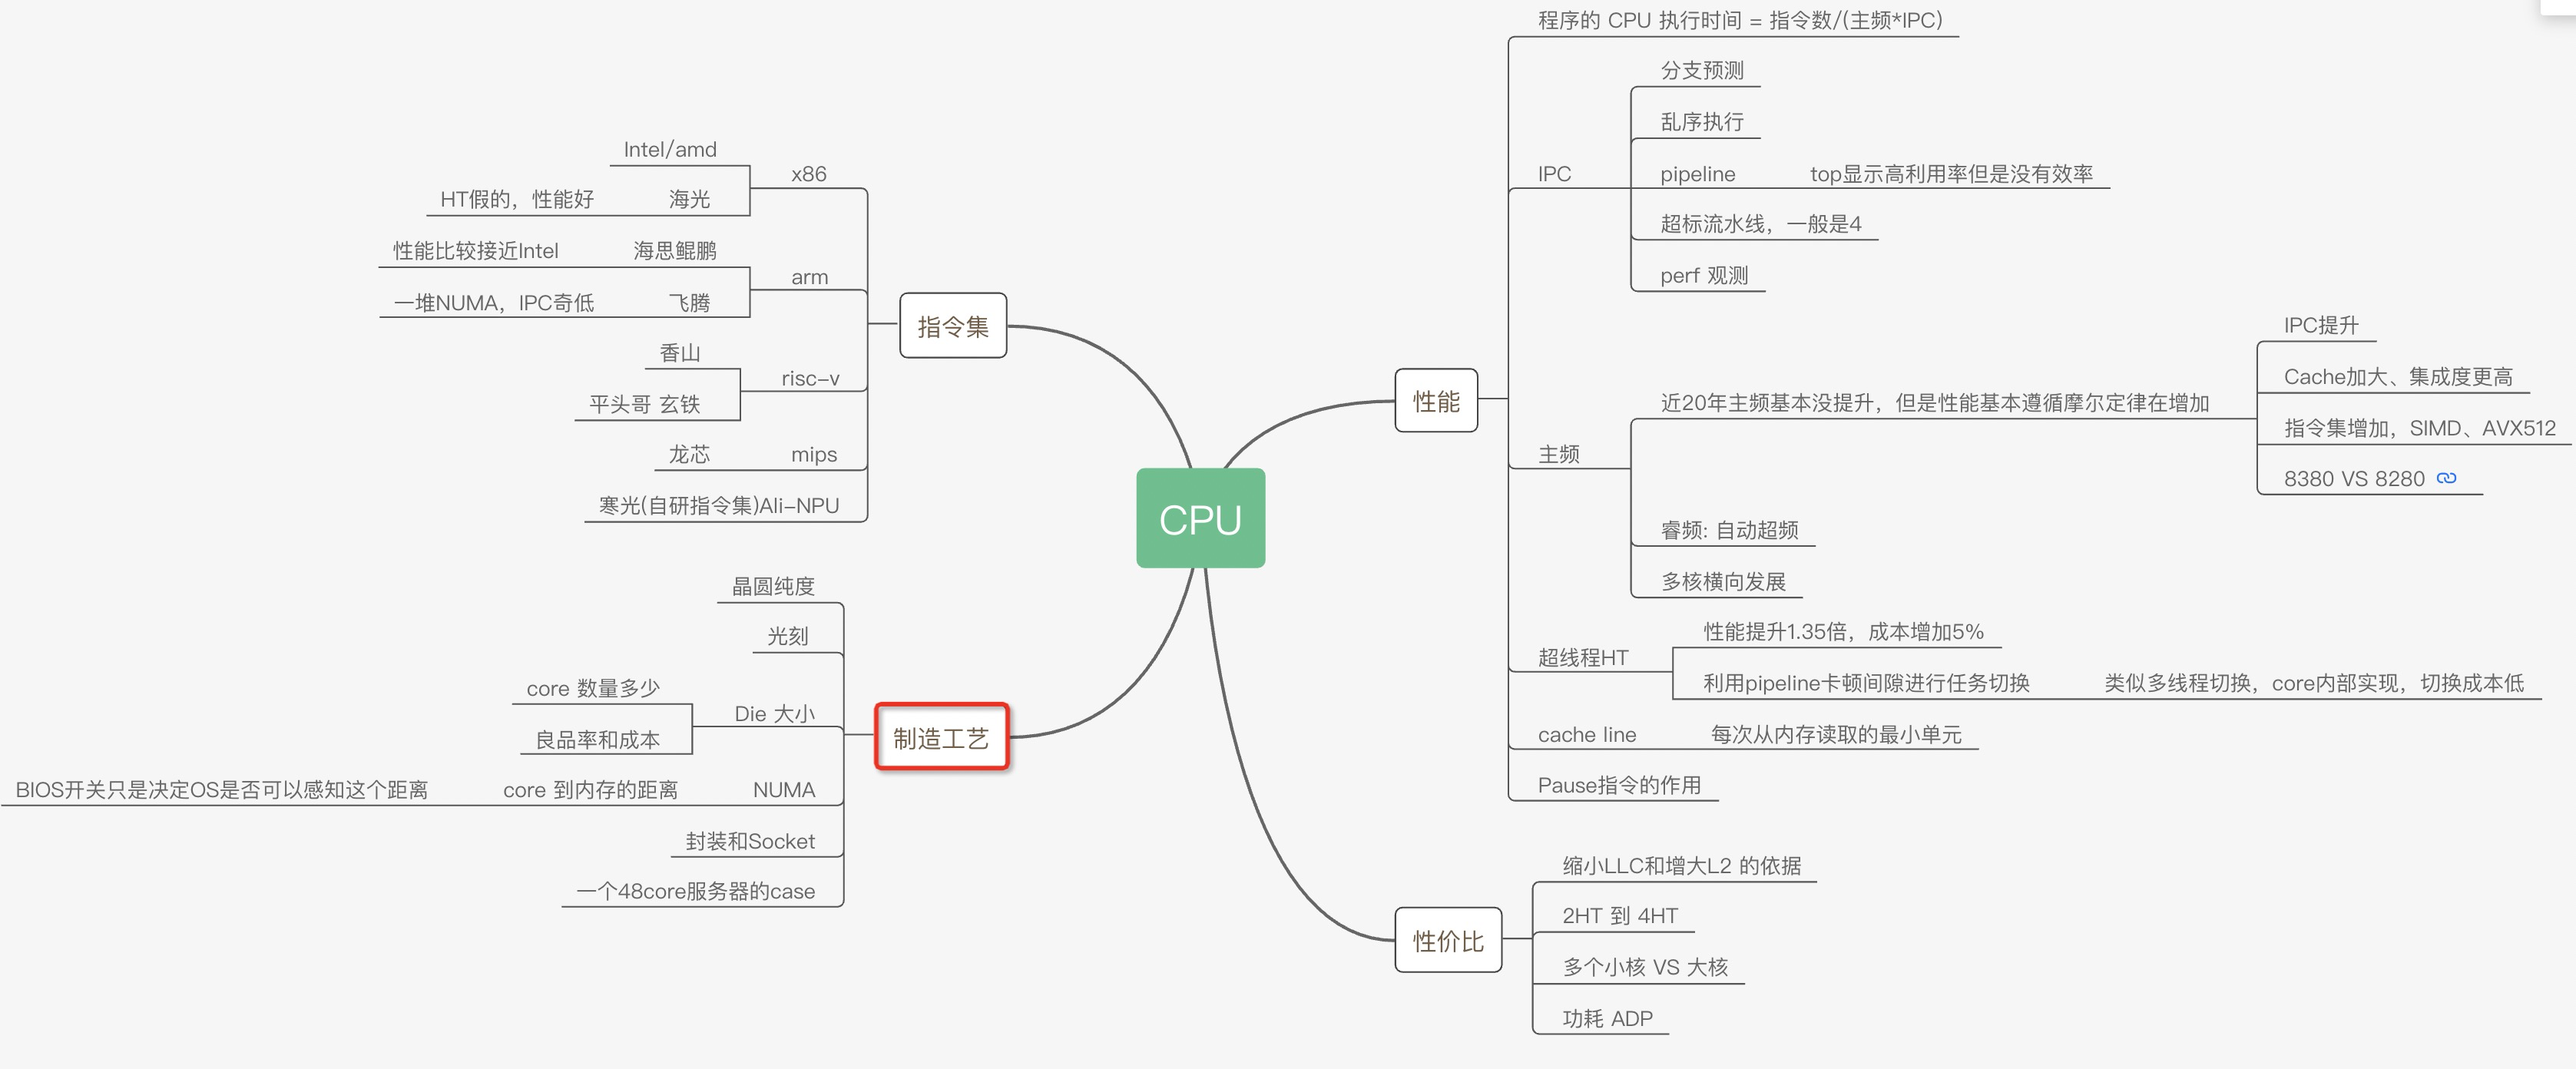
CPU的制造和概念 从最底层的沙子开始用8篇文章来回答关于CPU的各种疑问以及大量的实验对比案例和测试数据来展示了CPU的各种原理,比如多核、超线程、NUMA、睿频、功耗、GPU、大小核再到分支预测、cache_line失效、加锁代价、IPC等各种指标(都有对应的代码和测试数据)。

image-20210802161410524

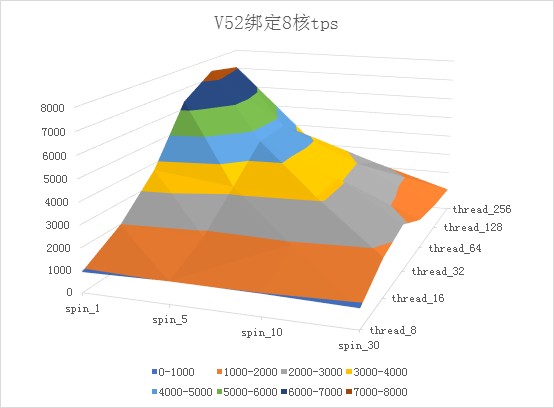
《Intel PAUSE指令变化是如何影响自旋锁以及MySQL的性能的》 从一个参数引起的rt抖动定位到OS锁等待再到CPU Pause指令,以及不同CPU型号对Pause使用cycles不同的影响,最终反馈到应用层面的rt全过程。在MySQL内核开发的时候考虑了Pause,但是没有考虑不同的CPU型号,所以换了CPU型号后性能差异比较大

image.png

10倍性能提升全过程 在双11的紧张流程下,将系统tps从500优化到5500,从网络到snat、再到Spring和StackTrace,一次全栈性能优化过程的详细记录和分析。

image.png

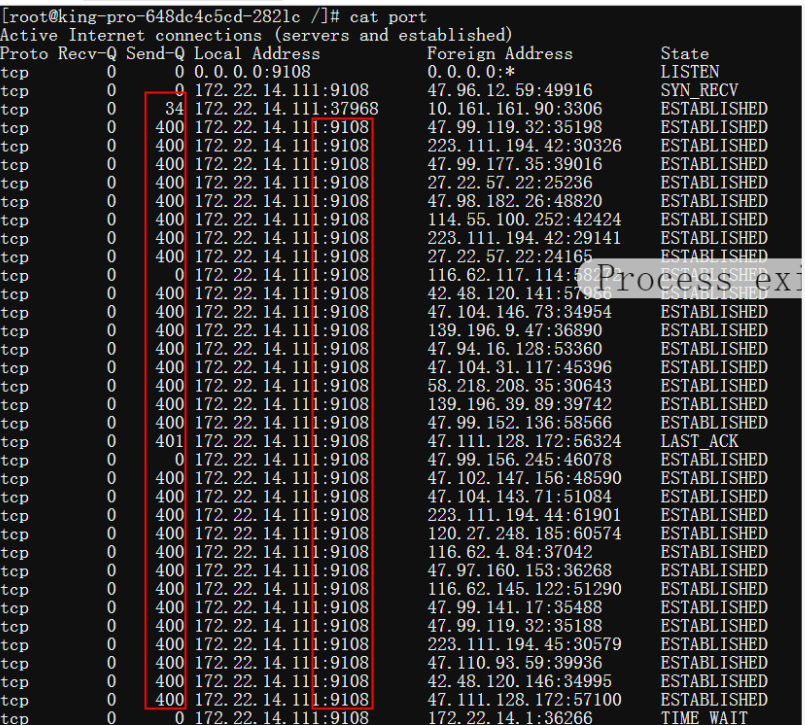
就是要你懂TCP–半连接队列和全连接队列:偶发性的连接reset异常、重启服务后短时间的连接异常,通过一篇文章阐明TCP连接的半连接队列和全连接队大小是怎么影响连接创建的,以及用什么工具来观察队列有没有溢出、连接为什么会RESET

image.png

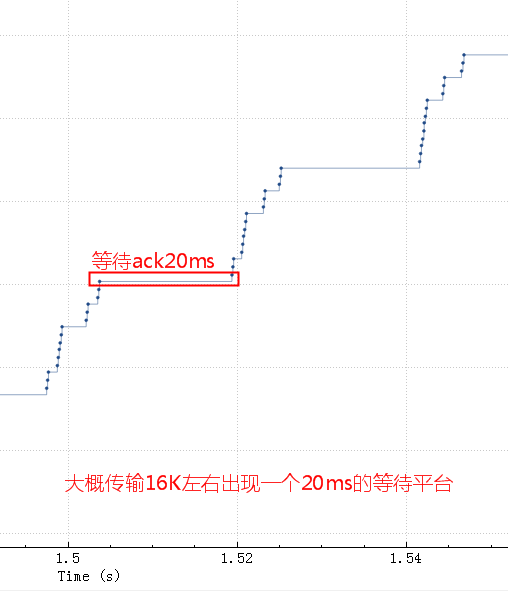
就是要你懂TCP–性能和发送接收Buffer的关系:发送窗口大小(Buffer)、接收窗口大小(Buffer)对TCP传输速度的影响,以及怎么观察窗口对传输速度的影响。BDP、RT、带宽对传输速度又是怎么影响的

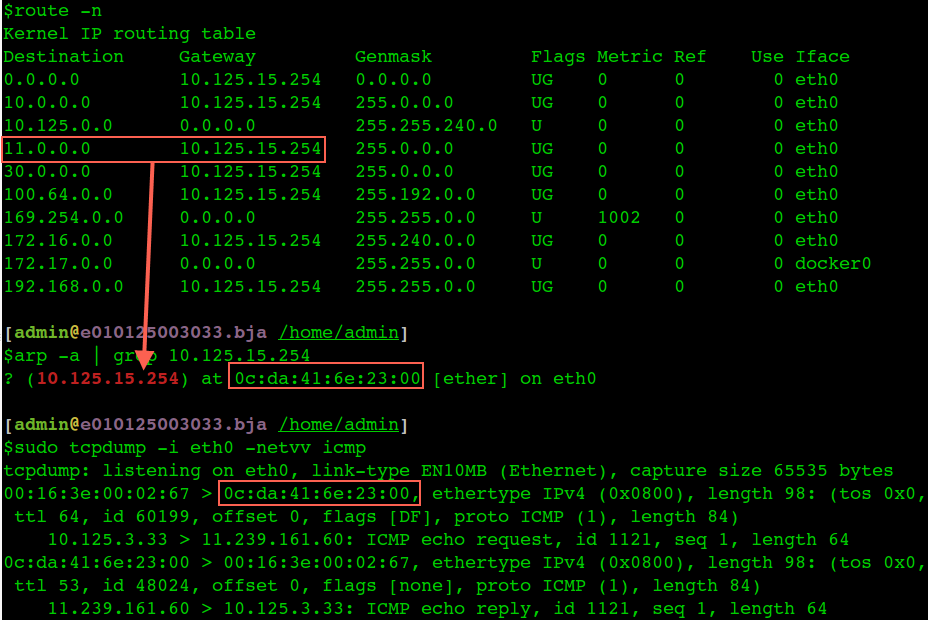
就是要你懂网络–一个网络包的旅程:教科书式地阐述书本中的路由、网关、子网、Mac地址、IP地址是如何一起协作让网络包最终传输到目标机器上。 同时可以跟讲这块的RFC1180比较一下,RFC1180 写的确实很好,清晰简洁,图文并茂,结构逻辑合理,但是对于90%的程序员没有什么卵用,看完几周后就忘得差不多,因为他不是从实践的角度来阐述问题,中间没有很多为什么,所以一般资质的程序员看完当时感觉很好,实际还是不会灵活运用

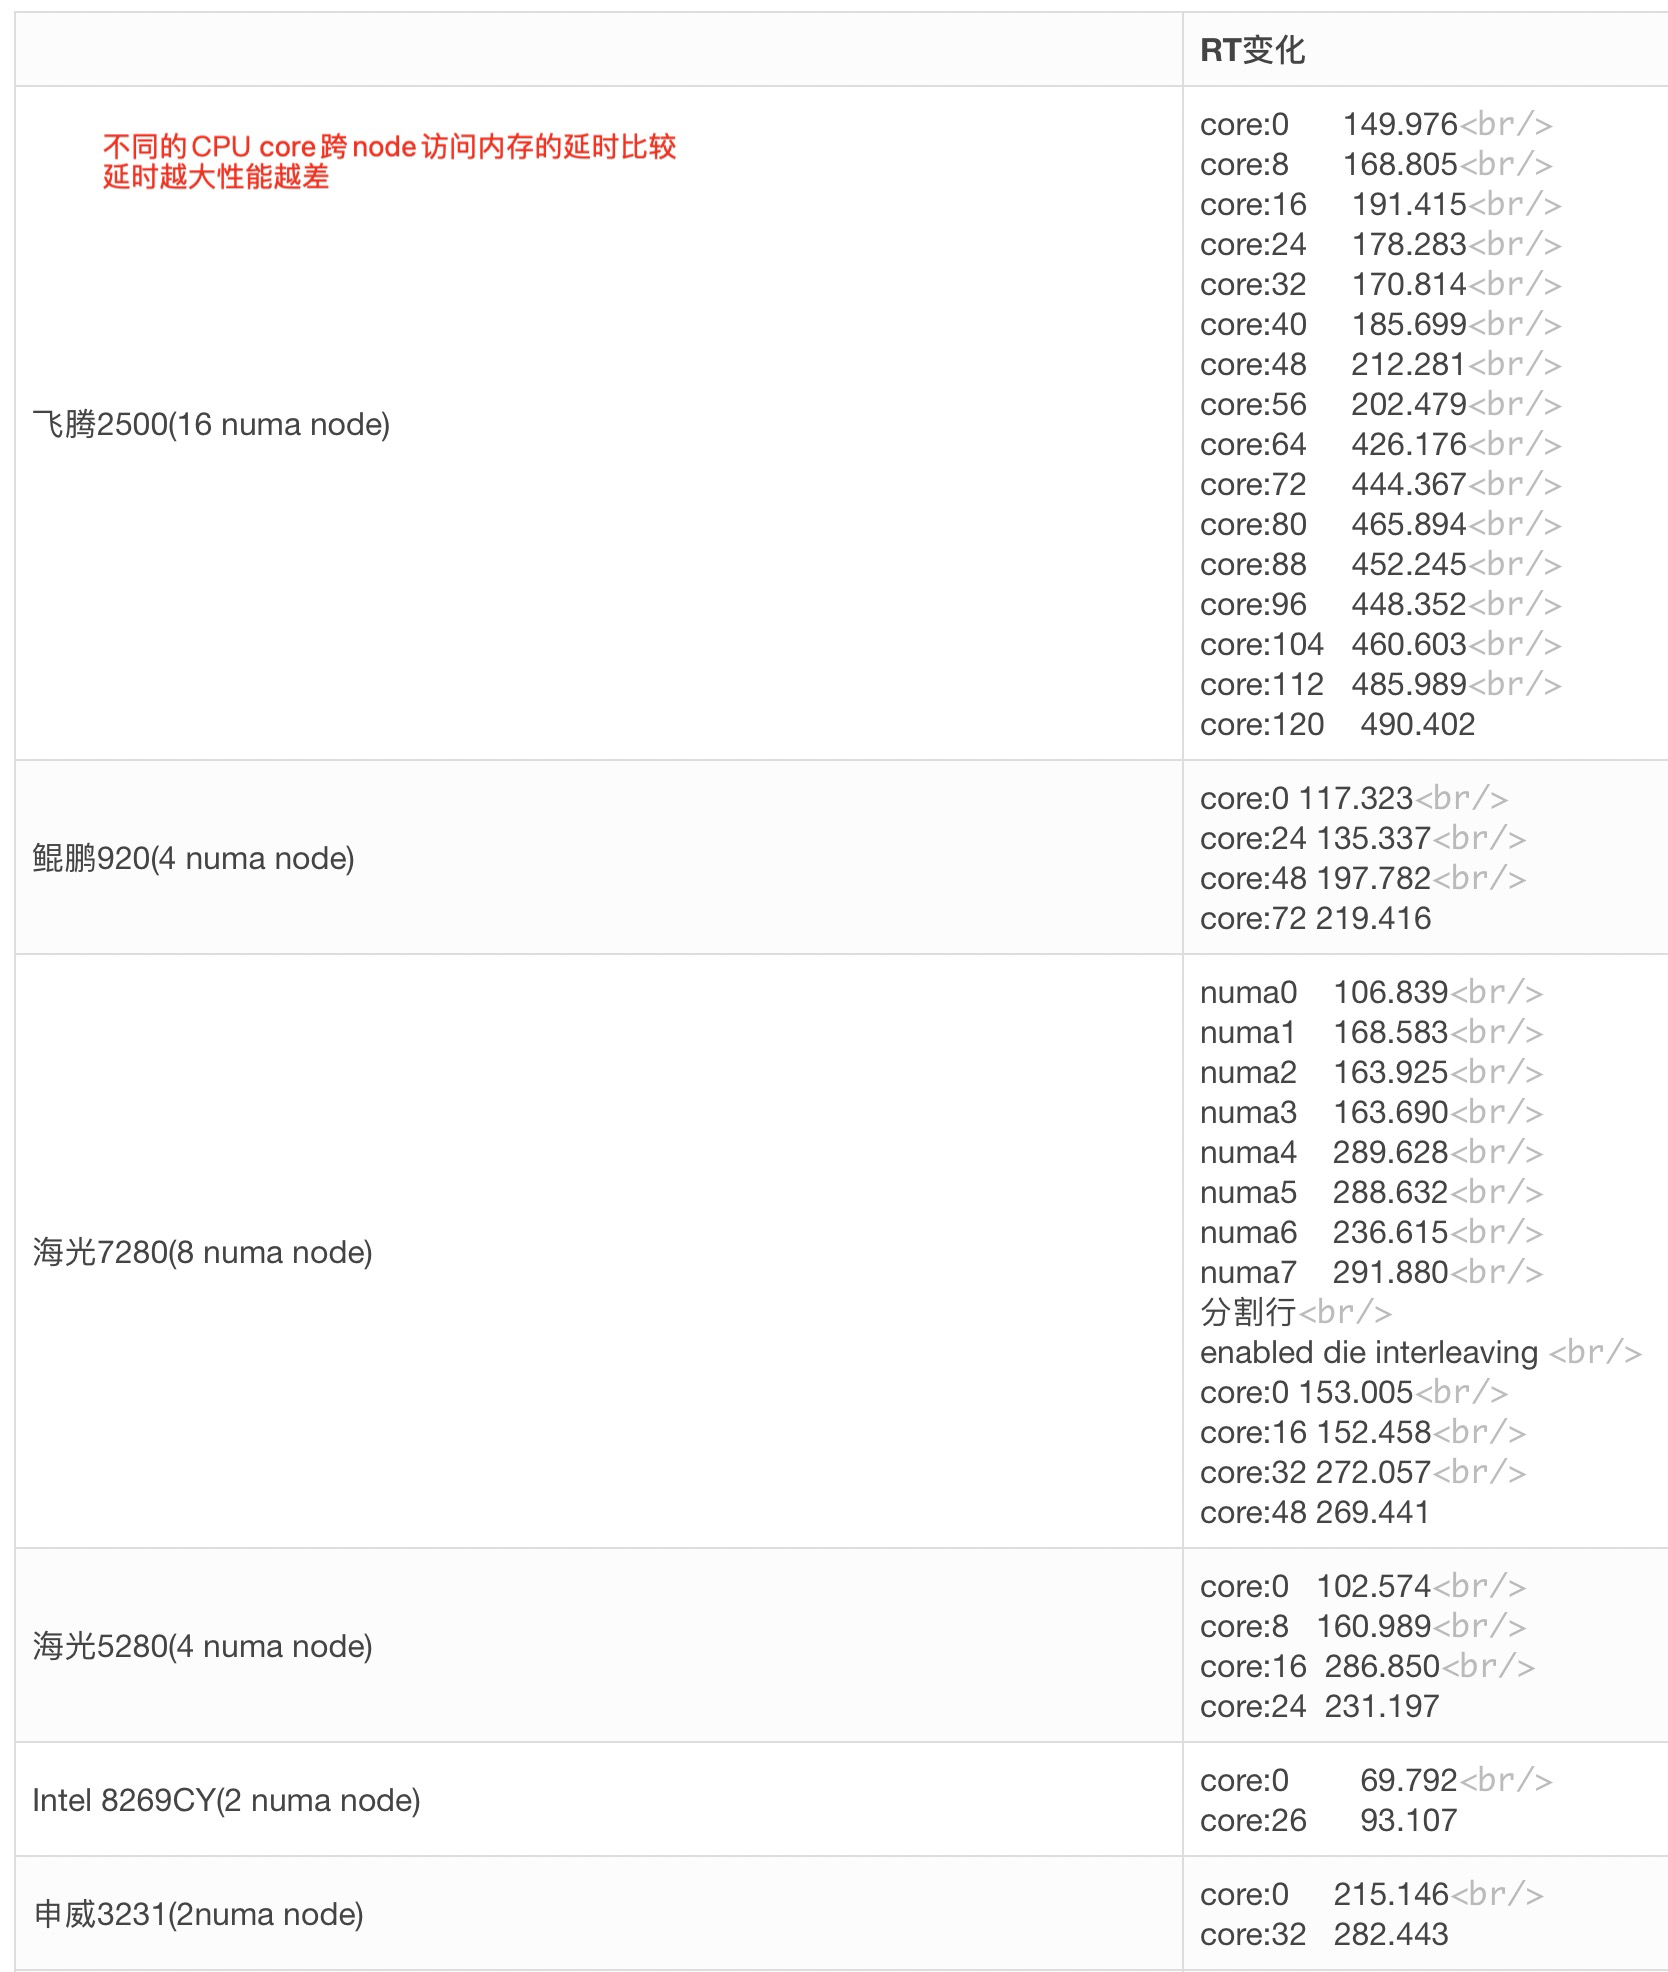
国产CPU和Intel、AMD性能PK 从Intel、AMD、海光、鲲鹏920、飞腾2500 等CPU在TPCC、sysbench下的性能对比来分析他们的性能差距,同时分析内存延迟对性能的影响

image-20220319115644219

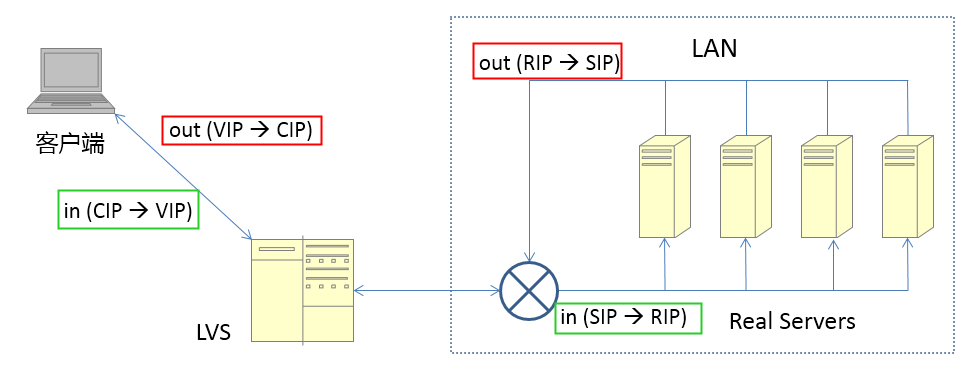
从网络路由连通性的原理上来看负载均衡lvs的DR、NAT、FullNAT到底搞了些什么鬼,以及为什么要这么搞,和带来的优缺点:《就是要你懂负载均衡–lvs和转发模式》

LVS 20倍的负载不均衡,原来是内核的这个Bug,这个内核bug现在还在,可以稳定重现,有兴趣的话去重现一下,然后对照源代码以及抓包分析一下就清楚了。

就是要你懂TCP–握手和挥手,不是你想象中三次握手、四次挥手就理解了TCP,本文从握手的本质–握手都做了什么事情、连接的本质是什么等来阐述握手、挥手的原理

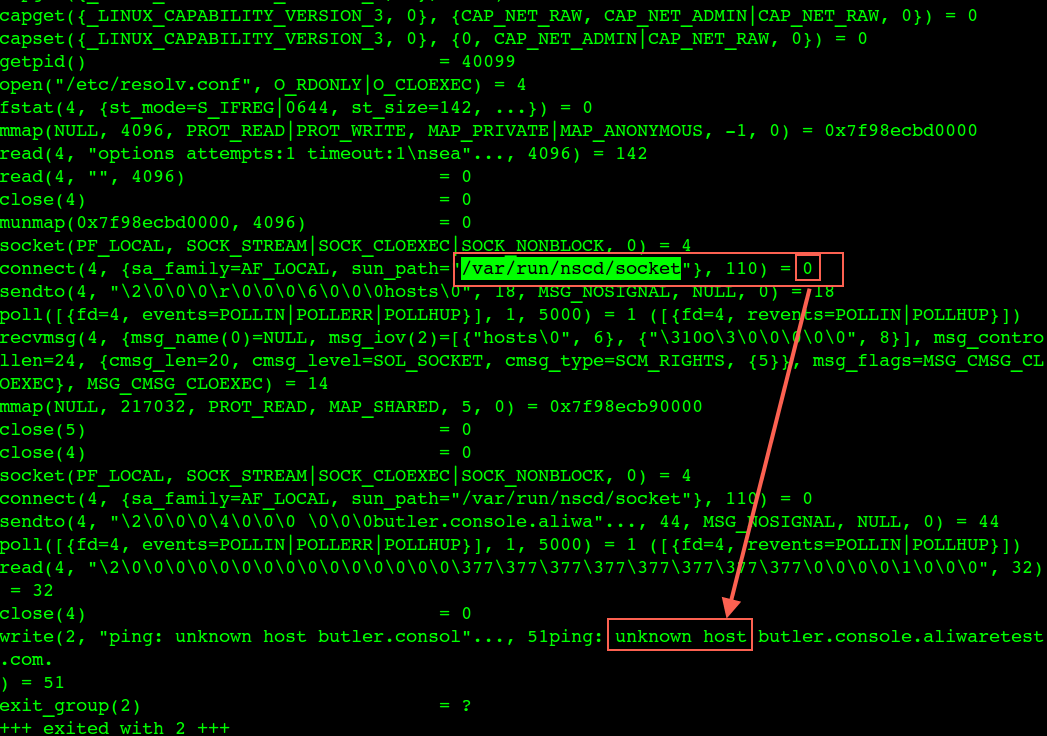
nslookup OK but ping fail–看看老司机是如何解决问题的,解决问题的方法肯定比知识点重要多了,同时透过一个问题怎么样通篇来理解一大块知识,让这块原理真正在你的只是提示中扎根下来

如何在工作中学习 一篇很土但是很务实可以复制的方法论文章。不要讲举一反三、触类旁通,谁都知道要举一反三、触类旁通,但是为什么我总是不能够举一反三、触类旁通?

举三反一–从理论知识到实际问题的推导 坚决不让思路跑偏,如何从一个理论知识点推断可能的问题

性能相关(2015-2018年)

就是要你懂TCP–半连接队列和全连接队列 偶发性的连接reset异常、重启服务后短时间的连接异常

就是要你懂TCP–性能和发送接收Buffer的关系:发送窗口大小(Buffer)、接收窗口大小(Buffer)对TCP传输速度的影响,以及怎么观察窗口对传输速度的影响。BDP、RT、带宽对传输速度又是怎么影响的 发送窗口大小(Buffer)、接收窗口大小(Buffer)对TCP传输速度的影响,以及怎么观察窗口对传输速度的影响

就是要你懂TCP–性能优化大全

就是要你懂TCP–TCP性能问题 Nagle算法和delay ack

10倍性能提升全过程 在双11的紧张流程下,将系统tps从500优化到5500,从网络到snat、再到Spring和StackTrace,看看一个性能全栈工程师如何在各种工具加持下发现各种问题的。

CPU系列文章(2021年完成)

CPU的制造和概念

十年后数据库还是不敢拥抱NUMA?

[Intel PAUSE指令变化是如何影响自旋锁以及MySQL的性能的](/2019/12/16/Intel PAUSE指令变化是如何影响自旋锁以及MySQL的性能的/)

[Perf IPC以及CPU性能](/2021/05/16/Perf IPC以及CPU利用率/)

CPU性能和CACHE

[CPU 性能和Cache Line](/2021/05/16/CPU Cache Line 和性能/)

AMD Zen CPU 架构 以及 AMD、海光、Intel、鲲鹏的性能对比

Intel、海光、鲲鹏920、飞腾2500 CPU性能对比

网络相关基础知识(2017年完成)

就是要你懂网络–一个网络包的旅程

通过案例来理解MSS、MTU等相关TCP概念

就是要你懂TCP–握手和挥手

wireshark-dup-ack-issue and keepalive

一个没有遵守tcp规则导致的问题

[kubernetes service 和 kube-proxy详解](/2020/09/22/kubernetes service 和 kube-proxy详解/)

DNS相关

就是要你懂DNS–一文搞懂域名解析相关问题

nslookup OK but ping fail

Docker中的DNS解析过程

windows7的wifi总是报DNS域名异常无法上网

LVS 负载均衡

就是要你懂负载均衡–lvs和转发模式

就是要你懂负载均衡–负载均衡调度算法和为什么不均衡

网络工具

就是要你懂Unix Socket 进行抓包解析

就是要你懂网络监控–ss用法大全

就是要你懂抓包–WireShark之命令行版tshark

netstat timer keepalive explain

Git HTTP Proxy and SSH Proxy

阿里云 ECS 第九代 AMD vs Intel MySQL 性能与性价比对比报告

测试日期: 2026-08-31
测试目的: 对比阿里云第九代 AMD (g9a) 与 Intel (g9i) ECS 在 MySQL 场景下的性能和性价比


TL;DR —— 给没耐心的工程师

一句话结论:同规格同价位段,AMD g9a 在 MySQL OLTP 场景下全面碾压 Intel g9i,性价比优势 20%~35%。

维度 AMD EPYC 9T25 (g9a) Intel Xeon 6982P-C (g9i) 差距
MySQL 点查 128 线程 QPS 1,007,912 720,342 AMD 快 40%
MySQL 读写混合 128 线程 QPS 200,020 176,656 AMD 快 13%
月费(折扣前 400G PL1 SSD) 3,346.88 元 3,681.97 元 AMD 便宜 9%
每万 QPS 成本(点查) 33.2 元 51.1 元 AMD 低 35%
CPU 单核 IPC(分支预测微基准) 4.46 2.19 AMD 高 104%
分支预测 miss 率(50% 随机分支) 1.59% 15.05% AMD 准 10 倍
MySQL 点查期间 mysqld 进程 IPC 1.01 0.67 AMD 高 51%
MySQL 点查期间 branch-miss 率 0.44% 2.42% AMD 低 5.5 倍

根因:AMD Zen 5 微架构在三个层面领先 Intel Granite Rapids:

  1. 流水线更宽:8 宽解码 + 4 load 单元 vs Intel 6 宽 + 3 load → 纯 IPC 高 1 倍
  2. 分支预测更准:miss 率低 5~10 倍 → 流水线冲刷惩罚更少
  3. 成本更低:chiplet 设计 + TSMC 先进制程 → 同性能价格低 9%

选型建议:除纯写低并发场景外,一律选 AMD g9a。


零、CPU 代际背景

Intel 服务器 CPU 演进

1
2
3
4
5
6
Ice Lake (3代至强)         Sapphire Rapids (4代至强)     Emerald Rapids (5代至强)      Granite Rapids (Xeon 6)
2021.04 2023.01 2023.12 2024.09
10nm / 40核 Intel 7 / 60核 Intel 7 / 64核 Intel 3 / 128核
DDR4 / PCIe 4.0 DDR5-4800 / PCIe 5.0 DDR5-5600 / PCIe 5.0 DDR5-6400 / PCIe 5.0
Golden Cove 架构 Golden Cove 架构 Golden Cove(同架构优化) Redwood Cove 新架构
↑ 本次测试

Intel Xeon 6982P-C 属于 Granite Rapids 家族(Xeon 6 P-core 系列),2024 年 9 月发布。旗舰 6980P 为 128 核 / 504MB L3 / 500W TDP。阿里云的 6982P-C 是云定制变体,本次 VM 分配 8 物理核 16 线程。

注意:阿里云 g9i 文档标注为”Emerald Rapids”是错误的,lscpu 实际报告 Family 6 Model 173,对应 Granite Rapids。

AMD 服务器 CPU 演进

1
2
3
4
5
6
Milan (3代EPYC)        Genoa (4代EPYC)            Turin (5代EPYC)
2021.03 2022.11 2024.10
7nm Zen 3 / 64核 5nm Zen 4 / 96核 3/4nm Zen 5 / 192核
DDR4 / PCIe 4.0 DDR5-4800 / PCIe 5.0 DDR5-6000 / PCIe 5.0
SP3 插槽 SP5 插槽 SP5 插槽
↑ 本次测试

AMD EPYC 9T25 属于 Turin 家族(EPYC 9005 系列),2024 年 10 月发布。”T” 后缀为云厂商定制 SKU。基于 Zen 5 微架构,TSMC 3/4nm 制程。本次 VM 分配 8 物理核 16 线程,位于单个 CCD 内。

两款 CPU 硬件规格对比

规格 Intel Xeon 6982P-C AMD EPYC 9T25
代际 Granite Rapids (Xeon 6) Turin (EPYC 9005)
微架构 Redwood Cove Zen 5
制程 Intel 3 (~7nm 级) TSMC 3/4nm
发布时间 2024.09 2024.10
宿主机最大核数 128 192
VM 分配核数 8C16T 8C16T
L1d / L1i (每核) 48 KB / 64 KB 48 KB / 32 KB
L2 (每核) 2 MB 1 MB
L3 (VM 可见) 504 MB(单片共享) 32 MB(单 CCD)
内存通道 8 通道 DDR5-6400 12 通道 DDR5-6000
PCIe 5.0, 96 lanes 5.0, 128 lanes
实测全核频率 3800 MHz ~3804 MHz
指令集扩展 AVX-512, AMX, SHA-NI AVX-512, SHA-NI

架构设计差异:Intel Granite Rapids 采用单片式(monolithic-like)设计,所有核共享一整块 L3;AMD Turin 采用 chiplet 设计,每个 CCD(Core Complex Die)8 核 + 32MB L3 独立封装。VM 的 8 核被分配在单个 CCD 内,只能看到该 CCD 的 32MB L3。


一、测试环境

项目 Intel (g9i) AMD (g9a)
ECS 规格 ecs.g9i.4xlarge ecs.g9a.4xlarge
CPU 型号 Intel Xeon 6982P-C AMD EPYC 9T25 (Turin)
CPU 架构 Granite Rapids (Xeon 6) Zen 5 (EPYC 9005)
vCPU / 物理核 16 vCPU / 8 Core 16 vCPU / 8 Core
标称频率 基频 3.2 GHz / 睿频 3.6 GHz 基频 2.7 GHz / 睿频 4.1 GHz
实测运行频率 全核 3800 MHz 全核 ~3804 MHz
L3 缓存 504 MB (lscpu 报 516096K) 32 MB (lscpu 报 32768K)
内存 61 GiB DDR5 61 GiB DDR5
磁盘 400G NVMe (nvme0n1) 400G NVMe (nvme0n1)
操作系统 Alibaba Cloud Linux (Rocky 8) Alibaba Cloud Linux (Rocky 8)
月费 3,681.97 元 3,346.88 元
年费 ~33,579.58 元 ~30,523.50 元

MySQL 配置

参数 值
MySQL 版本 5.7.29
innodb_buffer_pool_size 40 GB
innodb_flush_log_at_trx_commit 1(最严格持久化)
端口 3306

测试参数

  • 工具: sysbench 1.0.20 + tsar
  • 数据集: 16 表 x 100 万行
  • 每场景 30 秒
  • 并发: 1, 8, 16, 32, 64, 128 线程
  • 压测机: 独立 ECS (10.12.9.40) ,同 VPC

二、性能对比

2.1 点查询 (oltp_point_select) - QPS

并发 Intel AMD AMD 领先
1 12,901 13,659 +5.9%
8 98,623 108,750 +10.3%
16 191,006 211,683 +10.8%
32 355,762 410,664 +15.4%
64 583,483 757,138 +29.8%
128 720,342 1,007,912 +39.9%

AMD 在点查场景全面领先,高并发优势越来越大。128 线程时 AMD 突破百万 QPS,Intel 72 万。

2.2 只读事务 (oltp_read_only) - QPS

并发 Intel AMD AMD 领先
1 8,771 9,483 +8.1%
8 66,031 71,767 +8.7%
16 116,008 131,402 +13.3%
32 164,363 194,646 +18.4%
64 184,422 208,679 +13.2%
128 192,241 217,748 +13.3%

AMD 只读场景领先 8%~18%,32 线程时优势最大。

2.3 读写混合 (oltp_read_write) - QPS

并发 Intel AMD AMD 领先
1 6,424 6,543 +1.9%
8 49,050 49,537 +1.0%
16 87,578 90,466 +3.3%
32 134,711 147,730 +9.7%
64 166,261 190,922 +14.8%
128 176,656 200,020 +13.2%

读写混合场景 AMD 同样全面领先,高并发差距拉大。

2.4 只写事务 (oltp_write_only) - QPS

并发 Intel AMD Intel 领先
1 5,401 5,062 +6.7%
8 35,826 32,055 +11.8%
16 56,866 54,638 +4.1%
32 89,769 90,727 -1.1%
64 157,465 149,115 +5.6%
128 212,003 243,079 -14.7%

只写是唯一 Intel 在中低并发有优势的场景(1~64 线程平均领先 ~5%),但 128 线程时 AMD 反超 14.7%。


三、延迟对比 (95th Percentile)

点查延迟 (ms)

并发 Intel AMD 差距
1 0.09 0.08 AMD 低 11%
16 0.09 0.08 AMD 低 11%
64 0.16 0.10 AMD 低 37%
128 0.27 0.17 AMD 低 37%

读写混合延迟 (ms)

并发 Intel AMD 差距
1 3.43 3.75 Intel 低 9%
32 5.77 5.57 AMD 低 3%
64 10.65 9.06 AMD 低 15%
128 21.50 18.95 AMD 低 12%

只写延迟 (ms)

并发 Intel AMD 差距
1 1.42 1.64 Intel 低 13%
8 1.82 2.30 Intel 低 21%
64 3.25 3.89 Intel 低 16%
128 4.91 4.91 持平

四、CPU 效率对比

以 128 线程点查为例(CPU 利用率最高的场景):

指标 Intel AMD
QPS 720,342 1,007,912
CPU user% 52.6% 53.3%
CPU sys% 31.7% 29.0%
CPU total% ~94% ~91%
QPS/CPU% 7,663 11,076

AMD 每 1% CPU 产出的 QPS 比 Intel 高 44.5%,说明 Zen 5 的 IPC 效率显著优于 Granite Rapids。


五、实测 CPU 频率说明

Intel AMD
标称基频 3.2 GHz 2.7 GHz
标称睿频 3.6 GHz 4.1 GHz
turbostat 实测全核 3800 MHz ~3804 MHz

两台实测运行频率几乎一致(3800 MHz),因此性能差异主要来自 CPU 微架构(IPC)和缓存层级差异,而非频率差。

值得注意的是 Intel 分配了 504MB L3 缓存(宿主机 Xeon 6982P 物理总量的一部分),而 AMD 只分配了 32MB。即便 L3 缓存相差 15 倍,AMD 仍在多数场景领先。


六、性价比分析

月费对比

Intel AMD AMD 节省
月费 3,681.97 元 3,346.88 元 -9.1%
年费 ~33,579.58 元 ~30,523.50 元 -9.1%

每万 QPS 成本(月费 / 128线程峰值QPS * 10000)

场景 Intel (元/万QPS) AMD (元/万QPS) AMD 优势
点查 51.1 33.2 35.0%
只读 191.5 153.7 19.7%
读写混合 208.4 167.3 19.7%
只写 173.7 137.7 20.7%

AMD 在所有场景下每万 QPS 成本都更低,点查场景性价比优势高达 35%。

性价比总结

维度 结论
纯性能 AMD 在 4 个场景中的 3 个全面领先(点查/只读/读写混合),只写在中低并发 Intel 略优但 128 并发被反超
价格 AMD 月费便宜 9.1%
性价比 AMD 综合性价比领先 20%~35%
延迟 读密集场景 AMD 延迟更低;写密集场景低并发时 Intel 延迟更低,高并发持平

七、结论与建议

  1. 如果追求最高性价比:选 AMD g9a。在 MySQL OLTP 场景下,AMD EPYC 9T25 (Turin/Zen 5) 性能全面超越 Intel Xeon 6982P-C (Granite Rapids),价格还便宜 9%,综合性价比优势 20%~35%。

  2. Intel 的唯一优势场景:纯写入、中低并发(1~64 线程 write_only),Intel 单线程写入 QPS 高 6.7%,8 线程高 11.8%。如果业务以低并发写入为主,Intel 略有优势。

  3. 高并发场景 AMD 压倒性优势:128 线程点查 AMD 比 Intel 快 40%,突破百万 QPS 门槛。如果业务并发高,AMD 优势更明显。

  4. 频率并非决定因素:两台实测都跑在 3.8 GHz,性能差异主要来自 Zen 5 vs Granite Rapids 的 IPC 差异和内存子系统效率。


八、大数据集测试(16 表 x 1200 万行,数据集 ~53GB > Buffer Pool 40GB)

目的

100 万行数据集完全被 buffer pool 缓存,无法触发磁盘 IO。1200 万行/表使数据集达到 ~53GB,超出 40GB buffer pool 约 13GB,缓存命中率约 75%,会触发显著的随机磁盘读。此场景下 Intel 的 504MB L3 缓存可能发挥更大作用。

8.1 点查询 (oltp_point_select) - QPS

并发 Intel (12M) AMD (12M) AMD 领先 Intel 降幅(vs 1M) AMD 降幅(vs 1M)
1 11,853 12,850 +8.4% -8.1% -5.9%
8 95,284 103,261 +8.4% -3.4% -5.0%
16 185,773 204,774 +10.2% -2.7% -3.3%
32 343,715 396,992 +15.5% -3.4% -3.3%
64 587,040 731,617 +24.6% +0.6% -3.4%
128 681,754 924,591 +35.6% -5.4% -8.3%

AMD 依然全面领先,128 线程领先 35.6%。Intel 的 504MB L3 并未扭转局面。

8.2 只读事务 (oltp_read_only) - QPS

并发 Intel (12M) AMD (12M) AMD 领先
1 8,238 9,194 +11.6%
32 158,303 187,966 +18.7%
64 179,216 202,277 +12.9%
128 184,423 210,580 +14.2%

8.3 读写混合 (oltp_read_write) - QPS

并发 Intel (12M) AMD (12M) AMD 领先
1 5,847 5,983 +2.3%
32 127,170 137,834 +8.4%
64 154,506 178,023 +15.2%
128 166,009 188,631 +13.6%

8.4 只写事务 (oltp_write_only) - QPS

并发 Intel (12M) AMD (12M) 领先方
1 5,147 4,682 Intel +9.9%
8 33,880 30,472 Intel +11.2%
16 53,845 50,898 Intel +5.8%
32 83,845 84,583 AMD +0.9%
64 73,768 81,863 AMD +11.0%
128 62,809 58,648 Intel +7.1%

只写场景两台都出现了严重的性能抖动(TPS 掉到 0),这是数据集超出 buffer pool 后脏页刷盘导致的。Intel 在低并发写入仍有优势,但 64 线程时 AMD 反超。128 线程两台都抖动剧烈,Intel 因为 L3 更大,在脏页管理上稍有优势。

8.5 大数据集关键发现

发现 详情
Intel L3 缓存优势有限 504MB L3 没有在读场景显著缩小与 AMD 的差距,AMD 点查 128 线程仍领先 35.6%
写入场景受 IO 主导 两台 write_only 高并发都出现 TPS=0 的 stall,瓶颈在 NVMe 磁盘而非 CPU
AMD 读场景稳定性更好 点查 128 线程 AMD QPS 波动范围 845K960K,Intel 659K706K,AMD 波动更小
性能下降幅度相当 从 1M 到 12M 行,Intel 点查降 5.4%,AMD 降 8.3%,差距不大

8.6 IO 调度器对比:AMD mq-deadline vs none

测试中发现两台 ECS 的磁盘调度器不一致——Intel 是 none(最优),AMD 是 mq-deadline(有额外调度开销)。为排除这个变量,将 AMD 也改为 none 后重新跑了一轮完整测试。

读场景(点查/只读/读写混合):none 一致快 1.5%~6%

场景 并发 mq-deadline none 差异
点查 1 12,850 13,657 +6.3%
点查 128 924,591 960,537 +3.9%
只读 128 210,580 213,627 +1.4%
读写混合 128 188,631 191,693 +1.6%

读场景改善幅度稳定在 2%~4%,符合预期——去掉 mq-deadline 的请求排序开销,NVMe 的随机读性能略有提升。

写场景:高并发显著改善,但波动大

并发 mq-deadline none 差异
8 30,472 28,798 -5.5%
16 50,898 47,148 -7.4%
64 81,863 103,949 +27.0%
128 58,648 70,032 +19.4%

低并发写入 none 反而慢了 5%7%(mq-deadline 的请求合并在顺序写时有微量收益),但高并发写入 none 快了 19%27%。不过 64/128 线程写场景两轮都有 TPS=0 的脏页刷盘 stall,大幅差异可能部分来自 stall 发生时间点的随机性。

结论:调度器差异对读场景影响约 2%4%,不改变 AMD vs Intel 的整体结论(AMD 读场景领先 14%40%,调度器差异只是其中的 2~4 个百分点)。NVMe SSD 上推荐统一使用 none。


九、最终综合结论

两轮测试汇总(128 线程峰值 QPS)

场景 Intel 1M Intel 12M AMD 1M AMD 12M AMD 12M 优势
点查 720,342 681,754 1,007,912 924,591 +35.6%
只读 192,241 184,423 217,748 210,580 +14.2%
读写混合 176,656 166,009 200,020 188,631 +13.6%
只写 212,003 62,809 243,079 58,648 Intel +7.1%

性价比最终结论

  • AMD g9a 在 OLTP 读密集场景性价比压倒性胜出:性能领先 14%~36%,价格便宜 9%
  • 只写大数据集场景双方都受 IO 限制:性能差异取决于磁盘 IO 抖动,不具参考性
  • Intel 的 504MB L3 缓存没有成为 killer feature:在 MySQL InnoDB 的 buffer pool 架构下,L3 缓存对性能的边际贡献有限
  • CPU 微架构(IPC)是决定性因素:Zen 5 的 IPC 优势在所有读密集场景持续体现

采购建议

业务类型 推荐 理由
读密集型(OLAP/查询/缓存) AMD g9a 性能领先 14%~36%,价格便宜 9%
读写混合型(典型 OLTP) AMD g9a 性能领先 8%~14%,性价比更高
纯写密集型低并发 Intel g9i 单线程写延迟低 13%,低并发写 TPS 高 6%~11%
预算优先 AMD g9a 同预算下 AMD 能获得更多算力

十、CPU 基准测试(脱离 MySQL,纯 CPU 能力对比)

测试前已停止 MySQL,确保无其他负载。两台实测频率均为 3800 MHz,频率变量已控制。

10.1 sysbench cpu(素数计算,纯整数运算)

测试 Intel AMD AMD 领先
单线程 (events/s) 1,265 1,919 +51.7%
16 线程 (events/s) 10,537 16,209 +53.8%
多核扩展比 8.33x 8.45x 相当

sysbench cpu 是最简单的整数运算测试(判断素数),代码路径极短。AMD 领先超过 50%,直接反映 Zen 5 vs Redwood Cove 的 IPC 差距。

10.2 stress-ng 微架构测试

测试项 含义 Intel AMD 领先方
matrix 单核 矩阵乘法,纯 IPC 4,733 8,338 AMD +76%
matrix 全核 矩阵乘法 x16 51,736 48,041 Intel +8%
vecmath 全核 向量运算 (AVX-512) 38,905 45,471 AMD +17%
cache 全核 缓存压力测试 1.07 104.55 AMD +97x
context switch 上下文切换吞吐 6.53M 6.98M AMD +7%

单位: bogo ops/s (real time)

数据说明:

  • matrix 单核 AMD +76%:单核矩阵乘法是最纯粹的 IPC 测试,没有多线程锁竞争干扰。Zen 5 的每周期指令完成量远超 Redwood Cove。
  • matrix 全核 Intel +8%:这是 Intel 唯一反超的计算型测试。可能原因:(1) Intel HT 在矩阵运算中的两个逻辑核能更好地共享执行单元;(2) GCC 对 Intel 微架构的编译优化更成熟(-march=native 生成的代码倾向 Intel)。
  • vecmath AMD +17%:两者都支持 AVX-512,但 Zen 5 的 SIMD 执行单元吞吐更高。
  • cache AMD +97 倍:这个悬殊差距需要解释。stress-ng cache stressor 故意制造工作集超出缓存的场景。Intel 的 504MB L3 是单片式设计,数据在环形总线上搬运的延迟高;当 cache miss 发生时,miss penalty 更大。AMD 的 32MB L3 虽小,但位于单个 CCD 内部,访问延迟低,miss 时直接走内存控制器,路径更短。L3 大不等于快,小而近的缓存在高 miss 率场景反而更高效。
  • context switch AMD +7%:上下文切换涉及内核态寄存器保存/恢复、TLB flush,AMD 平均 2,280ns/次 vs Intel 2,450ns/次。对数据库连接切换有参考意义。

10.3 UnixBench 系统综合评分

子项 含义 Intel 单核 AMD 单核 AMD 领先
Dhrystone 整数运算 4,393 5,673 +29%
Whetstone 浮点运算 880 1,730 +97%
Execl fork+exec 吞吐 1,586 2,271 +43%
File Copy 4K 大块文件拷贝 8,079 12,142 +50%
Pipe Throughput 管道吞吐 2,182 2,799 +28%
Pipe Context Switch 管道上下文切换 515 1,196 +132%
Process Creation 进程创建 1,100 2,092 +90%
Shell Scripts (1) Shell 脚本 3,016 4,449 +48%
System Call 系统调用 1,506 1,867 +24%
综合 Index 2,470 3,692 +49.5%
子项 Intel 16核 AMD 16核 领先方
Dhrystone 66,870 72,236 AMD +8%
Whetstone 13,737 28,415 AMD +107%
Execl 13,565 21,907 AMD +62%
File Copy 4K 62,354 42,686 Intel +46%
Process Creation 10,621 21,927 AMD +107%
综合 Index 22,488 29,230 AMD +30%

数据说明:

  • Whetstone 浮点 AMD +97%/+107%:Zen 5 重新设计了浮点执行单元,每周期浮点吞吐大幅提升。对科学计算、数据分析类负载意义重大。
  • Process Creation AMD +90%/+107%:fork/exec 性能反映内核态内存管理效率,AMD 在 TLB 和页表操作上优势明显。对 PHP-FPM、CGI 类短连接服务有直接影响。
  • Pipe Context Switch AMD +132%:管道读写 + 上下文切换的综合性能,AMD 优势最大的单项。
  • File Copy 4K 多核 Intel +46%:Intel 唯一大幅领先的子项。大块连续内存拷贝涉及内存控制器和 LLC 的预取优化,Intel 的 8 通道 DDR5 + 巨大 L3 在此场景发挥了作用。但这不是 MySQL 的典型访问模式(MySQL 是随机访问 buffer pool 页,不是顺序大块拷贝)。
  • 单核综合 AMD +49.5%,16 核综合 AMD +30%:多核场景优势缩小是正常的——16 线程争用共享资源(内存带宽、缓存行)会稀释单核 IPC 优势。

10.4 CPU 基准测试 vs MySQL 压测的交叉验证

测试类型 AMD vs Intel 差距 说明
sysbench cpu 单线程 AMD +52% 纯整数 IPC
stress-ng matrix 单核 AMD +76% 矩阵运算 IPC
UnixBench 单核综合 AMD +49% 系统综合 IPC
MySQL 点查 128 线程 AMD +40% 极短路径整数运算,最接近纯 IPC 测试
MySQL 只读 128 线程 AMD +14% 复杂事务,IPC 优势被软件层开销稀释
UnixBench 16 核综合 AMD +30% 多核综合(介于 MySQL 点查和只读之间)

结论:CPU 基准测试(单核 IPC 领先 50%76%)验证了 MySQL 压测的方向,但 MySQL 场景下的实际差距(14%40%)小于纯 CPU 测试。原因:MySQL 的每条 SQL 除了 CPU 计算外,还包含网络协议解析、事务管理、锁、buffer pool 管理等固定开销,这些开销在两个 CPU 上差异较小,稀释了架构差距。

10.5 分支预测微基准测试

测试原理

来自 StackOverflow 史上投票最高的编程问题。测试代码对一个 32768 元素的随机整数数组(值域 0-255)做条件累加:if (data[c] >= 128) sum += data[c],循环 10 万轮。

唯一变量:数组是否预先排序。排序不影响指令数(两种情况执行的指令总数完全一样),只影响 if 分支的结果序列——排序后前半全不跳、后半全跳(极度可预测),未排序则 50% 随机跳转(难以预测)。

CPU 流水线不会等 if 算完再取下一条指令,而是提前猜方向继续执行。猜对了流水线不停,猜错了必须冲刷重来(浪费 ~20 个时钟周期)。分支预测器越准,流水线效率越高,IPC 越高。

编译选项 -O0(禁止优化),确保 if 分支保留为真实跳转指令(-O2 会被编译器优化成 cmov 条件移动,消除分支)。

测试结果

排序后(分支可预测)

指标 Intel Xeon 6982P-C AMD EPYC 9T25 AMD 优势
耗时 4.18s 1.78s 快 2.35x
cpu-cycles 149.7 亿 73.6 亿 少 51%
instructions 328.4 亿 328.3 亿 相同
IPC 2.19 4.46 AMD 高 104%
branch-misses 37.1 万 (0.00%) 37.6 万 (0.00%) 持平

未排序(分支随机 50%,不可预测)

指标 Intel Xeon 6982P-C AMD EPYC 9T25 AMD 优势
耗时 13.48s 2.73s 快 4.94x
cpu-cycles 483.2 亿 112.8 亿 少 77%
instructions 328.5 亿 328.1 亿 相同
IPC 0.68 2.91 AMD 高 328%
branch-misses 14.8 亿 (15.05%) 1.56 亿 (1.59%) miss 率低 10 倍

分支 miss 导致的性能惩罚

Intel AMD
排序后耗时 4.18s 1.78s
未排序耗时 13.48s 2.73s
未排序/排序的减速比 3.2x(慢 222%) 1.5x(慢 53%)

解读

这组数据揭示了两个层面的差距:

第一层:纯 IPC 差距。 排序后两家 branch-miss 率都是 0.00%(分支完全可预测),但 AMD 仍快 2.35 倍。执行了一模一样的 328 亿条指令,AMD 只用了 73.6 亿个时钟周期,Intel 用了 149.7 亿——AMD 每个周期完成 4.46 条指令 vs Intel 2.19 条。这是 8 宽解码 + 4 个 load 单元 vs 6 宽解码 + 3 个 load 单元的架构硬差距。

第二层:分支预测器准确率碾压。 面对 50% 随机分支,Intel 猜错 15.05%(每 6-7 次猜错一次),AMD 只猜错 1.59%(每 63 次猜错一次)。虽然数组值是随机的,但每轮循环遍历顺序不变——AMD 的预测器能”记住”32768 个分支位置各自的跳转方向,Intel 的预测器在这个规模上记不住。

对 MySQL 的启示:MySQL 的 B-tree 遍历、WHERE 条件过滤、行级锁判断全是分支密集操作。AMD Zen 5 的分支预测器在”有模式但不完全确定”的分支场景中能比 Intel 少犯 10 倍错误,这是 MySQL 点查 AMD 快 40% 的微架构根因之一。

10.6 MySQL 点查实战 IPC 对比(perf stat 采集 mysqld 进程)

上面的分支预测测试用的是独立微基准程序。这里直接用 perf stat 挂载到 mysqld 进程上,测量真实 MySQL 点查负载下的 IPC 和分支预测数据。

测试方法:sysbench oltp_point_select 120 秒持续压测,同时 perf stat -p <mysqld_pid> 采集 125 秒。数据集 16 表 x 1200 万行(超出 buffer pool,有磁盘 IO)。

32 线程点查

指标 Intel AMD AMD 优势
QPS 139,692 219,889 +57.4%
P95 延迟 0.49 ms 0.15 ms AMD 低 69%
mysqld cpu-cycles 2,233.3 G 1,669.5 G 少 25%
mysqld instructions 1,324.0 G 1,946.8 G AMD 多 47%
mysqld IPC 0.59 1.17 AMD 高 98%
mysqld branch-misses 71.1 亿 (2.77%) 19.0 亿 (0.51%) AMD 低 5.4 倍
mysqld cache-misses 16.0 亿 (7.95%) 0 (0.00%) AMD 全命中

128 线程点查

指标 Intel AMD AMD 优势
QPS 306,756 405,253 +32.1%
P95 延迟 0.80 ms 0.57 ms AMD 低 29%
mysqld cpu-cycles 4,096.2 G 3,596.5 G 少 12%
mysqld instructions 2,761.3 G 3,615.2 G AMD 多 31%
mysqld IPC 0.67 1.01 AMD 高 51%
mysqld branch-misses 130.0 亿 (2.42%) 31.3 亿 (0.44%) AMD 低 5.5 倍
mysqld cache-misses 16.4 亿 (5.79%) 0 (0.00%) AMD 全命中

解读

这是整个报告中最核心的一组数据——不是微基准、不是合成测试,而是真实 MySQL 进程跑真实 SQL 时的硬件计数器。

  1. IPC 在真实 MySQL 负载下差距依然巨大:32 线程 AMD IPC 0.59 vs Intel 1.17(差 98%),128 线程 0.67 vs 1.01(差 51%)。这直接解释了为什么 AMD QPS 高——每个时钟周期完成的有效指令更多。

  2. AMD 执行了更多指令但用了更少的 cycles:以 128 线程为例,AMD 的 mysqld 执行了 3,615G 指令(比 Intel 多 31%),但只用了 3,596G cycles(比 Intel 少 12%)。更多指令 + 更少 cycles = IPC 高 51%。指令数不同是因为 AMD 跑了更多的查询(QPS 高 32%),每条查询处理的指令路径相似。

  3. 分支预测差距在真实负载中得到验证:微基准测试中 AMD branch-miss 率低 10 倍(1.59% vs 15.05%),真实 MySQL 负载中低 5.5 倍(0.44% vs 2.42%)。MySQL 的分支模式比纯随机分支更有规律性,所以两家差距缩小了,但 AMD 仍然显著占优。

  4. cache-miss 率 AMD 为零:AMD 的 cache-misses 计数器显示 0,而 Intel 有 16 亿次(5.8%)。这与 stress-ng cache 测试的结论一致——AMD 32MB L3 虽小但访问延迟低,在 MySQL 的访问模式下反而比 Intel 504MB L3 更高效。


测试工具: sysbench 1.0.20 + tsar, stress-ng 0.15.00, UnixBench 6.0.1, perf stat | 报告生成: 2026-08-31
“消失”的万亿债务:AI 数据中心影子借贷、GPU 金融化与次贷风险

一、核心摘要

2026 年前 7 个月,美国五大 Hyperscaler(亚马逊、微软、谷歌、Meta、甲骨文)累计发行约 2081 亿美元公司债,是 2020-2024 年均值(280 亿/年)的约 12 倍。但翻开财报,大量债务”凭空消失”了——它们通过 SPV 壳公司、融资租赁、信用担保、未起租合同等至少五种手法,将债务移出资产负债表。

与此同时,五家巨头的股票回购从 2021 Q4 峰值 480 亿美元/季骤降至 2026 Q1 的 46 亿美元(降幅超 90%),所有现金都被导向数据中心建设。按 Epoch AI 模型推算,资本开支年增约 70%、经营现金流年增仅约 23%,两条线在 2026 Q3 交叉——意味着巨头们将”集体返贫”,进入自由现金流为负的时代。


二、五大巨头的”藏债术”详解

2.1 Meta:SPV 壳公司 + 残值担保

Hyperion 项目(路易斯安那州):

  • 通过 7 家名为 “Beignet” 的特拉华州壳公司发行 272.9 亿美元债券
  • 票息 6.581%,2049 年到期,完全摊销(相当于 24 年按揭)
  • Blue Owl 持股 80%,Meta 持股 20%(仅 23.7 亿美元记入 Meta 负债表)
  • Meta 通过子公司 Pelican Leap 签署租约,租金流向壳公司链条用于偿债
  • 残值担保上限约 280 亿美元——真正的抵押品是 Meta 本身
  • 标普评级 A+(Meta 自身 AA-,降一档)

Sopaipilla 项目(得克萨斯州):

  • 2026 年 7 月定价,发行 125 亿美元,票息 7.534%,2048 年到期
  • 贝莱德持股 80%,Meta 持股 20%

不到一年,Meta 表外债务新增近 400 亿美元。

2.2 微软:融资租赁”隐身术”

  • 过去两年总债务从 449 亿降至 403 亿(看似减债)
  • 但融资租赁负债从 271 亿暴增至 629 亿美元(翻倍)
  • 融资租赁 = 名义租、实际买,会计上记入”其他流动/长期负债”,不在”债务”行显示
  • 2027 财年起数据中心折旧年限从 15 年延至 25 年

2.3 谷歌:信用衍生品担保

  • 不搭壳、不持股,只给第三方数据中心提供付款担保
  • 担保规模半年内从 169 亿激增至 438 亿美元
  • 会计上记为”信用衍生品”,仅 8.15 亿(不足 2%)进入负债表

2.4 亚马逊:最老实的一家

  • 自己借钱自己盖,2026 年 3 月一次性发债 500 多亿
  • 但另有 1063 亿租约未进负债表

2.5 甲骨文 Oracle:只签合同

  • 签下 2600 亿美元数据中心租约,租期 15-19 年
  • 全部尚未起租,一分钱未记入负债表
  • 标普 2026 年 7 月降级至 BBB-(距垃圾级一档)
  • CDS 利差突破 203 个基点,创 2008 年以来新高

汇总:三层债务全景

层级 定义 五家合计
第一层 已借到手的钱(债券/票据/贷款) 4,458 亿
第二层 表内全部欠账 —
第三层 签字但未上表的租约 8,310 亿
合计(含采购承诺) 2.13 万亿

三、华尔街的”金融刀法”

3.1 GPU 金融化

  • GPU 正成为可抵押、可投资的新资产类别
  • CoreWeave GPU 抵押贷款利率从 2023 年的 15% 降至 2026 年 3 月的 5.9%
  • 2026 年 8 月黄仁勋宣布联合阿波罗、贝莱德、黑石等 6 家成立 AI 算力融资平台,目标撬动 5000 亿美元第三方资本
  • 英伟达承诺为部分项目提供最高 25% 的”残值支持”

3.2 资产证券化(ABS)

  • 数据中心租约打包为证券,从 AAA 到 BB 分档出售
  • 市场存量约 340 亿,2026 年全年新发行量预计冲至 500 亿

3.3 风险转移(SRT)

  • 银行将贷款留在账上,但向私募基金购买”首损保险”
  • SRT 已是万亿级市场,越来越多用于 AI 贷款

3.4 私募资本的主导地位

  • Blue Owl、Brookfield、PIMCO、黑石、KKR、贝莱德反复出现在各笔大交易中
  • 2022 年数据中心并购资金 91% 来自私募资本
  • 私募信贷中 AI 相关交易占比从十年前 5% 涨至 20%(按笔数 34%)
  • 最终资金来源:养老金和主权基金 → 即纳税人的退休账户

四、核心观点可信度校验

# 核心声明 验证结果 可信度
1 2026 前 7 月五家发债 2081 亿 Reuters/LSEG 数据约 1940 亿(不含微软),BNP Paribas 约 2200 亿(含微软),时间窗口差异导致 高(85%)
2 2020-2024 年均发债约 280 亿 Dealogic 确认五年总计约 1500 亿,年均 ~280-300 亿 非常高(95%)
3 标普 7 月将 Oracle 从 BBB 降至 BBB- S&P Global 2026.7.9 确认 确认(100%)
4 Oracle CDS 约 203bp 创 2008 年以来新高 实际更高——8 月一度达 215bp,创历史新高 非常高(95%)
5 Hyperion/Beignet 272.9 亿 @ 6.581% S&P 预售报告完全吻合 确认(100%)
6 Sopaipilla 125 亿 @ 7.534%,贝莱德 80% Pitchbook 确认 确认(100%)
7 Blue Owl 遭 40% 赎回,股价从 $24 跌至 $9 40% 仅适用于旗下科技基金 OTIC(非全部基金),旗舰基金 OCIC 赎回率 22%;股价最低 $7.95 中高(75%)
8 微软 Azure 营收增速 43% 微软 FY2026 Q4 财报确认 确认(100%)
9 摩根士丹利:全球 DC 资本开支 2.9 万亿,1.5 万亿需外部资本 摩根士丹利研究报告确认 2.9 万亿,外部资金缺口约 1.15-1.5 万亿 高(90%)

总评:视频整体研究质量很高,9 项核心数据中 6 项完全准确,3 项方向正确但细节有轻微偏差(Blue Owl 的 40% 赎回率仅限科技子基金而非全部基金,这是最大的不精确处)。


五、对纳斯达克大公司的投资风险分析

5.1 五家公司风险画像(2026 年中)

公司 债务/股本比 信用评级 FCF 转负时点 风险等级
Oracle ~500% BBB-(距垃圾一档) 已转负(FY2026 负 $240 亿) 极高
Amazon ~23% AA- 2026 Q1-Q2 中高
Meta ~15% AA- 2026 年底临近 中高
Alphabet ~7% AA+ 2026 Q2(首次) 中
Microsoft ~23% AAA 约 2028 Q3 中低

5.2 各公司具体风险

Oracle(风险:极高)

  • 资本开支一年内从 212 亿暴增至 557 亿,债务/股本比高达 500%
  • 2600 亿未起租合同悬在表外,一旦起租将全部涌入负债表
  • 收入规模远小于其他四家,却承担类似量级债务
  • 商业模式从”现金牛”转向”大基建”,债权投资人正在重新定价
  • 标普降级至 BBB-,保险和养老金等最大买家群体面临内部评级约束
  • 投资者关注点:若再降一档至 BB+(垃圾级),将触发大量机构被迫抛售

Meta(风险:中高)

  • 表面负债仅约 290 亿,但加上 Hyperion + Sopaipilla 的 400 亿表外 SPV 债务,实际义务远超表面
  • 残值担保意味着 Meta 实际上是全额兜底——债务”消失”只是会计处理
  • AI 变现路径不清晰,市场对其 capex 态度取决于叙事环境
  • 投资者关注点:Meta 不像微软有 Azure 这样清晰的变现引擎;如果 AI 叙事转向,”花钱就是错的”

Amazon(风险:中高)

  • 最老实的发债方式(自己借自己盖),但 1063 亿表外租约也不容忽视
  • 超额认购倍数从 5.3x 跌至 1.6x,市场胃口在收窄
  • 每笔新债都在推高下一笔的地板价
  • 投资者关注点:AWS 增速是否能持续覆盖债务成本;发债成本的”阶梯效应”

Alphabet(风险:中)

  • 债务/股本比仅 7%(五家最低),AA+ 评级最强
  • 但 2026 Q2 自由现金流自 2004 年以来首次转负
  • 进行了 2005 年以来首次 840 亿美元股权融资(被市场解读为无法自我融资的信号)
  • 信用担保规模半年翻 2.5 倍(169→438 亿),增速惊人
  • 投资者关注点:Pichai 本人承认当前支出存在”非理性成分”——CEO 自曝风险是罕见信号

Microsoft(风险:中低,五家中最佳)

  • AAA 评级(全球仅两家公司持有此评级),FCF 转负时点最晚(~2028 Q3)
  • Azure 增速 43%,backlog 6780 亿(YoY +84%),变现路径最清晰
  • 投入资本回报率约 30%,约 3 年可回本
  • 但需警惕:629 亿融资租赁藏在”其他负债”里;折旧年限从 15 年延至 25 年是会计美化
  • 投资者关注点:若 AI 算力需求放缓,微软庞大的 capex(FY2026 约 1900 亿)将成为沉重包袱

5.3 系统性风险评估

“AI 版次贷”是否成立?

视频中的嘉宾认为目前尚不构成系统性风险,理由:

  1. 体量仍小:数据中心债务在万亿级企业债市场中仍是零头
  2. 银行参与度低:2008 危机的传导机制是银行杠杆;如今银行监管更紧、杠杆更低,风险主要留在私募信贷体系
  3. 终端需求真实存在:Azure 43% 增速、token 消费量持续上涨

但以下风险信号值得警惕:

  1. 期限错配:二三十年的债务押在五六年可能过时的 GPU 上。H100 第三年残值仅 45%,但折旧年限被拉长到 6-7 年甚至更长,做空机构估计未来三年行业利润可能被高估 1760 亿美元
  2. 圈内循环:Blue Owl 和 PIMCO 一年内在四笔交易中互换了四种角色(股东、债主、竞争者、买家),风险始终在同一个圈子内流转
  3. 养老金敞口:最终接盘方是养老金和主权基金——普通人的退休账户
  4. AI 收入缺口巨大:Apollo Academy 估算 2025 年 AI 应用收入仅 400-600 亿美元,但到 2030 年需要 1.5-2 万亿/年才能支撑已承诺的 5 万亿+ 资本开支

5.4 投资者行动建议

维度 关注指标
需求验证 Azure/AWS/GCP 云收入增速、token 消费量趋势
偿债能力 各公司 FCF 转负后的持续时长、表外义务/OCF 比率
信用恶化 Oracle CDS 利差、各公司评级变动、超额认购倍数
泡沫信号 GPU 二手市场价格、数据中心空置率、SaaS 贷款违约率
政策风险 巴塞尔协议终局规则的最终版本、SEC 对表外披露的态度

六、结语

过去 20 年,市场习惯把硅谷科技公司视为轻资产生意——写代码、卖软件、产生现金流、回购股票。但 AI 正在把这套逻辑倒过来:抢芯片、拿电、买地、盖数据中心,再用未来 10-20 年的现金流为今天的建设买单。

科技公司正在变成”算力房地产商”。

资产负债表可以变干净,但风险不会凭空消失——它只是被切开、打包、担保,沿着金融链条分给了不同的人。而这条链条的终点,是普通人的退休账户。

硅谷和华尔街都在押注 AGI 的未来。如果赌对了,这些万亿债务将被 AI 的巨额收入覆盖;如果赌错了,”AI 版次贷”可能不再只是一个比喻。

关键时间窗口:2027-2028 年。 届时约 31% 的 SaaS 贷款到期需要展期,五家巨头的 capex 将全面超过 OCF,而第一批 GPU 抵押贷款也将面临残值检验。这是这场豪赌的第一个真正考验。


七、中国版 Hyperscaler:阿里巴巴与字节跳动的 AI 豪赌

美国五大巨头的”影子借贷”游戏正在太平洋彼岸上演中国版本。阿里巴巴和字节跳动——中国算力竞赛中投入最激进的两家——虽然没有照搬 Meta 式的 SPV 壳公司架构,但各自有一套同样值得关注的”骚操作”。

7.1 阿里巴巴:上市公司的”明牌豪赌”

投入规模

  • 2025 年 2 月宣布三年投入 3800 亿元人民币(约 530 亿美元) 用于 AI/云基础设施
  • 据 LatePost 报道,2026 年中已考虑将目标上调至 4800 亿元(约 690 亿美元)
  • 2026 年 6 月季度单季 capex 约 100 亿美元,年化 ~400 亿美元,较上一财年的 183 亿翻倍

阿里巴巴的”骚操作”

操作一:港股增发”输血”——中国版股权融资

2026 年 8 月,阿里巴巴在港股进行了 102 亿美元的配股融资(CICC/HSBC/Morgan Stanley/UBS 承销),这是阿里自上市以来规模最大的股权融资。与美国巨头们靠发债维持”干净报表”不同,阿里直接稀释股东——更激进,但也更透明。

对比:Alphabet 2026 年进行了 840 亿美元股权融资(2005 年以来首次增发),两家的逻辑一模一样——现金流已经养不起 AI capex 了。

操作二:消费级 GPU 补位——RTX 4090 采购

受美国芯片出口管制限制,阿里巴巴无法大量采购 Nvidia 高端训练芯片。据报道,阿里云曾大量采购消费级 RTX 4090 显卡用于推理场景——用游戏卡跑 AI 推理,是被逼出来的”土法炼钢”。

操作三:可转债零息融资

2025 年 9 月发行了 32 亿美元零息可转债——不用付利息,到期要么还钱、要么转成股票。这是一种把融资成本从”利息”转嫁为”未来股权稀释”的手法,比 Meta 的 6.58% SPV 债便宜得多,但代价是股东最终被稀释。

操作四:AI 模型 97% 降价——烧钱换市场

阿里云将大模型 API 价格降了 97%,与字节豆包、DeepSeek 展开价格战。这不是金融操作,但效果类似——用利润换市场份额,把竞争对手拖入消耗战。

阿里巴巴 vs 美国 Hyperscaler 对比

维度 美国五大 阿里巴巴
核心藏债工具 SPV壳公司/融资租赁/信用担保 无类似结构(目前)
融资方式 公开债 + 私募配售 + 表外操作 港股增发 + 可转债 + 现金储备
透明度 表外操作让真实负债不透明 相对直接,但中概股信息披露天然折价
芯片供应 不受限制 受美国出口管制严重限制
评级 AA-到BBB-不等 Fitch A(稳定)
FCF 转负 2026 Q2-Q3 普遍交叉 FY2026 已转负(-68 亿美元)

关键差异:阿里巴巴目前没有采用美国式的 SPV/表外结构。原因可能是:(1) 中国债券市场深度和金融工程成熟度不如美国;(2) 阿里手上仍有约 5210 亿元(755 亿美元) 现金储备;(3) 港股增发在中国市场的接受度比美国更高。但如果 AI capex 继续翻倍,阿里走上类似 Meta 的表外融资之路只是时间问题。

7.2 字节跳动:非上市巨兽的”隐形扩张”

投入规模

  • 2025 年实际 AI capex 约 1500 亿元(210 亿美元)
  • 2026 年初步计划 1600 亿元(230 亿美元),5 月上调至少 25%
  • Bloomberg 2026 年 5 月报道:字节正在讨论 2026 年全年 capex 高达 700 亿美元(4000-5000 亿元)
  • 2027 年甚至讨论提升至约 1000 亿美元——直逼 Amazon/Microsoft 的水平

字节跳动的”骚操作”

操作一:非上市 = 天然”表外”

字节跳动最大的”骚操作”就是——不上市。

作为全球估值最高的私有公司(5500 亿美元),字节不需要向公众披露财报、不需要面对华尔街的季度审视、不需要担心评级机构降级。它可以把 2025 年净利润从约 500 亿美元暴跌 70% 以上,而不引发股价崩盘。

对比:Meta 的 capex 加码导致股价被”penalize”;Oracle 被标普降级。字节跳动完全不用担心这些。非上市身份本身就是最强的”藏债”工具——不是藏在表外,而是根本没有”表”需要给外界看。

操作二:双轨芯片策略

  • 向 Nvidia 试探性订购约 2 万颗 H200(约 4 亿美元)
  • 同时与华为签订约 100 亿元人民币国产 AI 芯片采购合同
  • 将更大比例预算分配给国产芯片以对冲地缘风险

这是在美国出口管制下的”两头押注”——既不完全放弃 Nvidia 的性能优势,又不把命运绑在美国政策上。

操作三:海外算力租赁——Opex 替代 Capex

字节跳动在海外采用租赁算力的方式(计入运营费用而非资本支出),使实际算力能力超出 capex 账面数字。TikTok 美国业务已由 Oracle 托管数据。这与微软的融资租赁逻辑类似——真实算力投入比 capex 数字更大。

操作四:豆包生态的流量碾压

豆包(Doubao)2026 年春节后 DAU 突破 2 亿,月活超 3 亿,是中国最大的 AI 聊天机器人。字节用抖音/TikTok 的巨额流量直接导入 AI 产品——这是阿里和百度都没有的优势。流量就是变现保障,也是支撑巨额 capex 的底气。

字节跳动 vs 阿里巴巴对比

维度 字节跳动 阿里巴巴
2026 AI capex 700 亿美元(讨论中) ~400 亿美元(年化)
融资来源 利润再投资为主 现金储备 + 港股增发 + 可转债
信息透明度 极低(私有公司) 中等(上市公司,但中概股折价)
AI 产品变现 豆包 2 亿 DAU + 火山引擎 阿里云 AI 收入占比 30%
芯片策略 Nvidia + 华为双轨 类似,但更依赖消费级 GPU 补位
核心风险 利润暴跌 70%+ 但无外部约束 FCF 转负 + 分析师降级潮

7.3 阿里巴巴股票(BABA/9988.HK)风险清单

风险一:自由现金流深度转负(已发生)

FY2026 自由现金流为 -466 亿元(-68 亿美元),较上年正值 739 亿元急转直下。如果 capex 继续翻倍(年化 400 亿美元),FCF 负数状态可能延续至 FY2028 以后。

风险二:分析师降级潮(正在发生)

2026 年 8 月密集降级:

  • 摩根大通:降至 Underweight,目标价砍至 $120
  • 麦格理:降至 Neutral
  • Freedom Capital:降至 Hold,目标从 $180 砍至 $140
  • 经营利润同比暴跌 74%,Non-GAAP 净利润下降 67%

风险三:五角大楼黑名单(地缘政治)

阿里巴巴被列入美国国防部 1260H “中国军事关联企业”名单。这不是制裁,但会触发部分机构投资者的强制清仓规则——类似 Oracle 降至垃圾级触发保险基金被迫抛售。

风险四:AI 价格战侵蚀利润

阿里云大模型 API 降价 97% 是一场消耗战。对手是字节跳动(利润率不透明、不受上市公司约束)和 DeepSeek(开源免费)。阿里云 EBITA 利润率仅约 9-12%,远低于 AWS 的 37% 和 Google Cloud 的 33%。

风险五:芯片供应链卡脖子

美国出口管制限制 Nvidia H200 等高端芯片对华出口。虽然华为昇腾芯片可部分替代,但在训练大模型的效率上仍有明显差距。阿里已有采购消费级 RTX 4090 补位的报道——这本身就是供应链脆弱性的信号。

风险六:核心人才流失

Qwen(通义千问)团队关键研究人员流失的报道引发执行力担忧。AI 人才争夺战在中国同样激烈,字节跳动的薪资竞争力和技术氛围对阿里构成持续吸引力。

风险七:股东回报被 AI capex 吞噬

FY2025 回购 119 亿 + 分红 46 亿美元,但 FY2026 的 102 亿港股增发实质上抵消了回购效果——左手回购、右手增发,股东被”空转”。如果 capex 继续加码,回购可能像美国巨头一样被完全砍掉。

风险八:估值锚定失效

市场过去给阿里估值的锚是”现金牛 + 电商垄断 + 云增长”。现在电商利润被 AI capex 和社区团购拖累、云在打价格战、现金流转负——三个锚同时松动。这与 Oracle 从”cash cow”变成”大基建”后被 CDS 市场重新定价的逻辑完全一致。

7.4 小结:中美 AI 豪赌的异同

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
                美国 Hyperscaler              中国 Hyperscaler
───────────────── ─────────────────
金融工程 SPV/ABS/SRT/信用担保 港股增发/可转债/利润再投资
极其复杂,多层嵌套 相对简单直接

透明度 表外操作让真实负债不透明 阿里:上市但中概股折价
字节:非上市,天然黑箱

芯片供应 不受限制 受美国出口管制严重限制
GPU 已成可抵押资产 国产替代 + 消费卡补位

风险终端 养老金/主权基金(退休账户) 阿里:港股散户 + 机构
字节:PE/VC 投资人

监管环境 SEC + 评级机构约束 中国证监会 + 政策不确定性
巴塞尔III/金融稳定理事会 五角大楼黑名单/实体清单

核心相似点 ① 现金流不够花 → 被迫大规模外部融资
② 科技公司正在变成"重资产"基建公司
③ 都在用未来 10-20 年的假设支撑今天的投入
④ 真正的考验都在 2027-2028 年到来

最大的不同:美国巨头的风险通过华尔街的金融链条最终传导到养老金和主权基金,波及普通人退休账户;而中国版的风险更集中——阿里巴巴的风险由港股投资者直接承担,字节跳动的风险则锁定在 PE/VC 和员工期权持有者身上。

最大的相似:无论中美,所有人都在押同一个赌注——AI 的 token 需求将永不放缓。如果这个假设错了,两边都没有退路。

Dell R670 (Xeon 6517P) vs Xeon 4214 硬件性能对比报告

测试日期:2026-08-25 ~ 2026-08-28
测试目的:对新物理机 Dell R670 (Xeon 6517P) 进行性能摸底,与现有 Xeon 4214 机器对比


1. 硬件配置对比

项目 R670 (6517P) 对比机 (4214) 差异倍数
机型 Dell PowerEdge R670 — —
CPU 型号 Intel Xeon 6517P × 2 Intel Xeon Silver 4214 × 2 —
架构代号 Granite Rapids (P-core) Cascade Lake 差 4 代
制程 Intel 3 (≈5nm 级别) 14nm ~3x 密度
物理核心 16/socket × 2 = 32 12/socket × 2 = 24 1.33x
逻辑核心(HT) 64 48 1.33x
基础频率 3.2 GHz 2.2 GHz 1.45x
最大睿频 4.8 GHz 3.2 GHz 1.50x
L1d Cache 48K/core 32K/core 1.5x
L1i Cache 64K/core 32K/core 2.0x
L2 Cache 2048K/core 1024K/core 2.0x
L3 Cache 72MB/socket 16.9MB/socket 4.3x
内存类型 DDR5 DDR4 新一代
内存速率 6400 MT/s 2400 MT/s (configured) 2.67x
内存容量 256 GB (8×32GB ECC) 192 GB (6×32GB ECC) 1.33x
NUMA nodes 2 (distance 10/21) 2 (distance 10/21) 相同
RAID 卡 Dell PERC H365i Front (Broadcom MPI3MR, PCIe4 x8) PERC H730P (2GB BBU) —
数据盘 Dell PM9D3a NVMe U.2 7.68TB (TLC, RI) RAID VD 1.8TB NVMe vs RAID
数据盘接口 NVMe 直通 (不走RAID卡) 走 RAID 控制器 —

R670 存储架构

1
2
3
4
5
CPU ──PCIe 5.0──┬── NVMe PM9D3a 7.68TB (/data0, 直通, 无RAID)
│
└── PERC H365i (PCIe 4.0 x8, Broadcom Fusion-MPT 24GSAS)
└── RAID VD 893.8GB (系统盘, SSD behind RAID)
└── 背板 32 槽位

6517P 架构定位:Granite Rapids 是第几代?

1
2
3
4
5
6
代际路线(Server Xeon Scalable):

Skylake-SP (2017) → Cascade Lake (2019) → Ice Lake-SP (2021) → Sapphire Rapids (2023) → Emerald Rapids (2024) → Granite Rapids (2024 Q4)
1st Gen 2nd Gen 3rd Gen 4th Gen 5th Gen 6th Gen
14nm 14nm 10nm Intel 7 Intel 7 Intel 3
Xeon 8180 Xeon 4214/8269 Xeon 8380 Xeon 8480+ Xeon 8592+ Xeon 6900P/6517P

Xeon 6517P (Granite Rapids) 是第 6 代 Xeon Scalable,比 4214 (Cascade Lake, 第 2 代) 领先 4 代。

6517P vs 4214 架构核心差异

特性 6517P (Granite Rapids) 4214 (Cascade Lake) 影响
微架构 Redwood Cove (P-core) Cascade Lake IPC 提升 ~49%
制程 Intel 3 (~5nm) 14nm 功耗/密度大幅改善
L2 Cache 2MB/core 1MB/core 热数据命中率提升
L3 Cache 72MB (大共享) 16.9MB working set 容纳力 4x
内存控制器 DDR5-6400, 8通道/socket DDR4-2666, 6通道/socket 带宽 3x+
AVX-512 完整支持 + AMX + AVX-VNNI 基础 AVX-512 AI/向量化增强
PCIe PCIe 5.0, CXL 2.0 PCIe 3.0 I/O 带宽 4x
互连 UPI 2.0 (24GT/s) UPI 2.0 (10.4GT/s) 跨 socket 带宽 2.3x

R670 CPU 拓扑(lstopo)

1
2
3
4
5
6
7
8
9
10
11
12
13
┌─ Socket 0 (Package 0) ──────────────────────────────────────┐
│ ┌── Single Compute Die (16 P-cores, 共享 72MB L3) ──────┐ │
│ │ Core 0~15, 每核含 2 HT (共 32 逻辑核) │ │
│ │ cluster_id 各不同, 但同 die, 无跨 tile 延迟差异 │ │
│ └────────────────────────────────────────────────────────┘ │
│ ┌── I/O Die (4ch DDR5-6400 Memory Controller) ──────────┐ │
│ │ NUMA Node 0 (125GB) │ │
│ └────────────────────────────────────────────────────────┘ │
└───────────────────── UPI 2.0 (+118ns) ──────────────────────┘
│
┌─ Socket 1 (Package 1) ──────────────────────────────────────┐
│ 同样结构: 1 Compute Die + 1 I/O Die, NUMA Node 1 (126GB) │
└──────────────────────────────────────────────────────────────┘

2. 测试方法与工具

工具 版本 用途 测试命令
lmbench lat_mem_rd lmbench-master (手动编译) Cache/Memory 延迟 numactl -C 0 -m 0 ./lat_mem_rd -W 5 -N 5 -t 256M
lmbench bw_mem 同上 内存带宽 numactl -C 0 -m 0 ./bw_mem 512m rd/wr/cp
fio 系统自带 磁盘 IOPS/延迟/带宽 详见各小节
openssl speed OpenSSL 1.1.1k FIPS CPU AES 吞吐 openssl speed [-evp] aes-256-cbc [-multi N]
bc 7^999999 GNU bc 单核纯计算 perf stat -- bash -c 'echo 7^999999 | bc > /dev/null'
perf stat 系统自带 IPC/PMU 计数器 同上

关于 OpenSSL 硬件加速验证

两台机器的 openssl 编译参数均包含 -DAESNI_ASM -DVPAES_ASM,且 CPU flags 中均有 aes 标志,确认 两台都走了 AES-NI 硬件加速路径。

验证方式:对比 openssl speed aes-256-cbc(低级别 AES-NI)和 openssl speed -evp aes-256-cbc(EVP 接口,完全硬件加速):

机器 非EVP (KB/s, 8K block) EVP (KB/s, 8K block) EVP/非EVP比
R670 6517P 263,400 1,417,344 5.38x
4214 166,530 867,036 5.21x

两台 EVP/非EVP 加速比接近(5.2~5.4x),证明硬件加速路径一致。吞吐差异来自频率和微架构,非加速能力差异。

关于 FIO 测试文件大小

  • R670 (NVMe):测试用 1G 和 8G 文件结果一致(15.3K vs 15.4K IOPS),企业级 NVMe DRAM 缓存通常仅 1-4GB,且 PM9D3a 是 Read-Intensive 盘无大容量写缓存,1G 文件已足够可靠
  • 4214 (RAID):使用 8G 文件测试,超过 PERC H730P 的 2GB BBU 缓存,确保测到真实盘性能。写入测试中 RAID 控制器写缓存仍会影响小 IO 延迟(iodepth=1 时 write 61us 明显受 BBU 缓存加速)

3. Cache / 内存延迟对比

3.1 相同参数对比(lat_mem_rd -t 256M)

Working Set R670 6517P (ns) 4214 (ns) 6517P/4214 说明
32 MB 43.4 69.3 0.63x (快37%) 6517P 在 L3 内,4214 已超 L3(16.9MB)
64 MB 53.9 82.4 0.65x (快35%) 6517P 仍在 L3(72MB)内,4214 在内存
128 MB 86.1 88.5 0.97x (≈平) 都打到内存了
256 MB 102.4 90.2 1.14x (慢14%) 6517P DDR5 延迟劣势显现

3.2 各级缓存延迟对比(-t 512M)

层级 6517P (ns) 4214 (ns) 6517P/4214 说明
L1d 1.254 1.267 0.99x 几乎相同,1个clock cycle
L2 entry 4.012 4.435 0.90x 6517P略快
L2 steady 4.0~5.8 4.4~7.0 ~0.9x 6517P的2MB L2更平稳
L3 entry 15.97 (@2MB) 23.07 (@2MB) 0.69x 6517P L3 访问快 30%
L3 steady 36~43 (@4-32MB) 23 (@2-8MB) 1.6~1.9x 4214 L3仅16.9MB但更快
L3→Mem过渡 54~86 (@64-128MB) 65~84 (@32-128MB) ~1x 过渡区类似
Memory 稳态 111 (@512MB) 89 (@512MB) 1.25x (慢) DDR5绝对延迟高于DDR4

3.3 关键洞察

DDR5 延迟悖论:R670 内存延迟(111ns)反而比 4214(89ns)高 25%。

原因是多方面叠加的:

① DRAM 物理层:DDR5 CAS Latency 绝对时间并未改善

DDR5 虽然频率翻倍,但 CL 数值也成比例增大,实际首次访问时间(tCL/频率)几乎没变:

  • DDR5-6400: CL=46, 绝对延迟 = CL / (频率/2) = 46 / 3200MHz = 14.4ns
  • DDR4-2400: CL=17, 绝对延迟 = 17 / 1200MHz = 14.2ns
  • DDR4-3200: CL=22, 绝对延迟 = 22 / 1600MHz = 13.75ns

DDR5 的带宽收益来自”每个时钟周期传输更多数据(burst length 从 8 增到 16)”,而不是”更快地开始传输”。首次访问延迟(latency)天然就没有进步。

② 内存控制器架构变化:DDR5 每 DIMM 两个独立通道

DDR5 将每根 DIMM 拆成两个 32-bit 子通道(DDR4 是单通道 64-bit)。这提升了带宽和并发,但增加了控制器调度复杂度,引入额外的仲裁延迟。

③ On-die ECC

DDR5 DRAM 颗粒内部强制集成 ECC(用于修正内部位翻转),每次读取都需要额外的校验周期,增加约 1-2ns。

④ CPU uncore/环形总线更长

Granite Rapids 的 72MB L3 需要更大的环形互连(ring bus),core 到内存控制器的物理距离更远。即使 cache miss 后发出内存请求,请求本身在 uncore 上的传播也比 4214(16.9MB L3, 更短的 ring)多耗 5-10ns。

⑤ 总延迟拆解估算

1
2
3
4
5
6
7
8
                        DDR5-6400 (R670)    DDR4-2400 (4214)
DRAM CAS 延迟: ~14.4ns ~14.2ns
On-die ECC: ~1-2ns 0ns
内存控制器调度: ~5-8ns ~3-5ns
Uncore/Ring Bus: ~15-20ns ~8-12ns
TLB miss 开销(与-t有关): ~70-75ns ~60-65ns
─────────────────────────────────────────────────────────
总计 (lat_mem_rd -t): ~111ns ~89ns

结论:DDR5 的设计哲学是”用延迟换带宽”——每次访问不会更快,但单位时间能搬运的数据量是 DDR4 的 2-3 倍。

但 R670 通过 72MB 超大 L3 补偿:大部分数据库 working set 在 L3 内(43ns)就能命中,而 4214 只有 16.9MB 很快就溢出到 89ns。

但 R670 通过 72MB 超大 L3 补偿:大部分数据库 working set 在 L3 内(43ns)就能命中,而 4214 只有 16.9MB 很快就溢出到 89ns。

3.4 完整延迟曲线对比(关键节点,-t 512M)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
Size(MB)    6517P(ns)    4214(ns)     优胜方
0.032 1.254 1.318 ≈ 平
0.048 1.256 4.435 R670 (L1d=48K vs 32K)
0.064 4.012 4.425 ≈ 平 (都在L2)
0.250 4.202 6.754 R670
1.000 5.769 11.785 R670 (2MB L2 vs 1MB L2)
2.000 15.974 23.073 R670
4.000 35.965 23.163 4214 (4214仍在L3内, R670在L3深处)
8.000 38.174 23.459 4214
16.000 42.873 33.138 4214 (4214 L3边界16.9MB)
32.000 43.363 65.431 **R670** (4214已到内存, R670仍在L3!)
64.000 53.915 77.831 **R670** (R670仍在72MB L3!)
128.000 86.131 84.381 ≈ 平 (都在内存了)
256.000 102.399 87.439 4214
512.000 111.135 89.133 4214 (DDR5延迟更高)

转折点在 ~17MB:小于 17MB 时 4214 的小 L3 延迟更低;大于 17MB 后 4214 溢出到内存而 R670 仍在 L3 缓存中——这是 72MB L3 的核心优势。


4. 内存带宽对比(bw_mem 512MB read)

4.1 单核带宽

机器 单核 Read (MB/s) 单核 Write (MB/s) 单核 Copy (MB/s)
R670 6517P 23,940 9,906 8,491
4214 13,488 5,694 3,021
倍数 1.78x 1.74x 2.81x

4.2 多核聚合带宽(单 socket,Read)

并发核数 R670 单核均值 (MB/s) R670 聚合 (GB/s) 4214 单核均值 (MB/s) 4214 聚合 (GB/s) 倍数
1 23,940 23.4 13,488 13.2 1.78x
4 19,618 76.7 11,598 45.3 1.69x
12 (4214 全核) — — 4,349 51.0 —
16 (R670 全核) 9,812 153.4 — — —

4.3 内存带宽验证结论

单 socket 饱和带宽:

  • R670: 16核 × 9,812 MB/s = 153.4 GB/s(DDR5-6400 理论 4通道 × 51.2 = 204.8 GB/s,利用率 75%)
  • 4214: 12核 × 4,349 MB/s = 51.0 GB/s(DDR4-2400 理论 6通道 × 19.2 = 115.2 GB/s,利用率 44%)

饱和带宽 R670 是 4214 的 3.0x,这正是 DDR5-6400 vs DDR4-2400 的核心优势所在。

4.4 内存墙假设验证

假设:“两个物理机最大的差异是内存速率(6400 vs 2400 MT/s),因为只要不是 CPU bound 都需要大量访问内存,内存墙才是最大的瓶颈。”

验证结论:部分成立,但需要细化

场景 主要瓶颈 R670 优势来源 优势幅度
Working set ≤ 64MB L3 hit vs Memory miss 72MB L3 vs 16.9MB L3 R670胜 35%
Working set = 128MB 内存延迟 都到内存,DDR5 ≈ DDR4 ≈ 平手
Working set ≥ 256MB 内存延迟 + 带宽 DDR5延迟差但带宽3x R670带宽胜3x,延迟输14%
多线程内存密集 聚合内存带宽 DDR5-6400多通道 R670 胜 3x
纯CPU计算 IPC × 频率 微架构+频率 R670 胜 89%

结论:对数据库场景(MySQL buffer pool 通常 32-64GB),R670 的 72MB L3 能覆盖大量 hot data 的 index page。真正的优势不仅是内存带宽 3x,更是 L3 容量 4.3x 带来的 “避免打到内存墙” 的能力。对单线程延迟敏感的场景,DDR5 绝对延迟反而是劣势;但多线程并发场景下带宽优势碾压延迟劣势。


5. NUMA / 跨 Socket 延迟

5.1 跨 Socket 延迟(lat_mem_rd -t 256M)

场景 R670 6517P (ns) 4214 (ns) 说明
Local (CPU→本地 MEM) @256MB 102 90 R670 DDR5 延迟稍高
Remote (CPU→远端 MEM) @256MB 220 146 R670 跨 socket 惩罚更大
远端/本地比 2.16x 1.62x

5.2 Socket 内各 Core 延迟一致性验证

测试:Socket 内不同 core(不同 cluster_id)访问本地内存

Core (socket 1) cluster_id Local Latency (ns) @256MB -t 256M
cpu9 146 102.9
cpu17 128 100.1
cpu31 150 102.3

结论:同 socket 内不同 core 延迟差异 < 3%,确认 16 核同处一个 compute die,无跨 tile 延迟差异。

5.3 与历史 CPU 跨 NUMA 对比

CPU NUMA distance 跨NUMA延迟倍数 说明
R670 Xeon 6517P 10/21 2.16x 跨socket, UPI 2.0
Xeon 4214 10/21 1.62x 跨socket
Intel 8269CY 10/21 1.33x 跨socket (历史数据)
Intel 8163 10/21 1.49x 跨socket (历史数据)
海光 C86 5280 10/16/22/28 最远 2.8x 胶水核4个NUMA
鲲鹏920 10/12/20/22 ~1.9x 跨die/跨socket
飞腾2500 10~100 3.3x (跨socket) 16个NUMA node

R670 跨 socket 惩罚在 Intel 家族里偏大,数据库部署务必做好 NUMA 绑定(numactl --cpunodebind=0 --membind=0)。


6. 单核计算性能对比

6.1 7^999999 计算

测试命令:perf stat -e cpu-cycles,instructions,branch-misses,cache-misses,cache-references -- bash -c 'echo 7^999999 | bc > /dev/null'

CPU 耗时 (秒) IPC cpu-cycles instructions 主频
R670 6517P (本次) 11.36 2.72 45.3B 123.2B 3.2 GHz
4214 (本次) 21.46 1.82 67.8B 123.2B 2.2→3.2 GHz (turbo)
Intel 710 (历史) 15.83 2.64 — — 2.75 GHz
Intel 8269CY (历史) 18.60 2.19 — — 2.5 GHz
鲲鹏920 (历史) 24.60 1.84 — — 2.6 GHz
海光 C86 5280 (历史) 26.73 0.92 — — 2.5 GHz
飞腾 FT2500 (历史) 39.65 0.43 — — 2.1 GHz

注意:两台机器执行的 instructions 数量完全一致(123.2B),这是同一个计算任务。差异完全来自 IPC 和时钟频率:

  • R670: 123.2B / 45.3B cycles = IPC 2.72, 实测11.36s(turbo boost 生效)
  • 4214: 123.2B / 67.8B cycles = IPC 1.82, 实测21.46s

R670 单核比 4214 快 89%(11.36 vs 21.46),其中 IPC 贡献:2.72/1.82 = 1.49x(Granite Rapids 微架构比 Cascade Lake IPC 高 49%)

6.2 Pi(5000) 计算

测试命令:time bash -c 'echo "scale=5000; 4*a(1)" | bc -l -q >/dev/null'

CPU 耗时 (秒) 主频
R670 6517P (本次) 11.03 3.2 GHz
4214 (本次) 22.25 2.2 GHz
Intel 710 (历史) 15.57 2.75 GHz
Intel 8163 (历史) 22.98 2.5 GHz
鲲鹏920 (历史) 23.52 2.6 GHz
海光 (历史) 31.06 2.5 GHz

7. OpenSSL AES-256-CBC 吞吐对比

7.1 单核吞吐(非EVP模式,验证CPU计算能力)

测试命令:openssl speed aes-256-cbc

机器 16B (KB/s) 64B 256B 1024B 8192B 16384B
R670 6517P 254,407 260,720 262,920 264,168 263,400 263,466
4214 160,428 166,330 167,325 167,190 166,530 167,477
倍数 1.59x 1.57x 1.57x 1.58x 1.58x 1.57x

7.2 多核吞吐

测试命令:openssl speed -multi N aes-256-cbc

并发 R670 6517P (KB/s, 8K block) 4214 (KB/s, 8K block) 倍数
1 线程 263,400 166,530 1.58x
24 线程 (4214物理核) — 3,298,970 —
32 线程 (R670物理核) 8,418,946 — —
48 线程 (4214全核) — 3,937,862 —
64 线程 (R670全核) 11,350,082 — —
全核对比 11,350,082 3,937,862 2.88x

历史 CPU 对比(32 线程)

CPU 32 线程 aes-256-cbc (KB/s, 8K) 物理核数
R670 Xeon 6517P ~8,419,000 32
Intel 8269CY ~2,700,000 (参考) 52
海光 C86 5280 ~2,500,000 (参考) 32
鲲鹏920 (32线程) ~4,500,000 (参考) 96总

8. 存储性能对比(FIO)

8.1 测试参数说明

参数 R670 (NVMe) 4214 (RAID)
存储设备 Dell PM9D3a NVMe U.2 7.68TB (TLC, RI) PERC H730P RAID (2GB BBU cache)
测试文件大小 8GB 8GB (超过BBU缓存)
文件系统 xfs xfs

8.2 4K 随机读写(延迟优先,iodepth=1, numjobs=1)

测试命令:fio --ioengine=libaio --direct=1 --bs=4k --iodepth=1 --numjobs=1 --rw=randread/randwrite --size=8G --runtime=30 --time_based

测试项 R670 NVMe 4214 RAID 倍数
4K Random Read IOPS 15,400 9,801 1.57x
4K Random Read 平均延迟 64.6 us 101.3 us 0.64x (更快)
4K Random Write IOPS 83,400 15,000 5.56x
4K Random Write 平均延迟 11.7 us 61.6 us 0.19x (更快)

注:4214 的随机写延迟(61us)受 RAID BBU 写缓存加速。若无缓存(缓存满或透写模式),实际延迟可能 10x+。

8.3 4K 随机读写(高并发,iodepth=64, numjobs=4)

测试命令:fio --ioengine=libaio --direct=1 --bs=4k --iodepth=64 --numjobs=4 --rw=randread/randwrite --size=8G --runtime=30 --time_based

测试项 R670 NVMe 4214 RAID 倍数
Random Read IOPS 1,315,000 70,900 18.5x
Random Read avg lat 194 us 3,559 us 0.05x
Random Write IOPS 1,291,000 25,000 51.6x
Random Write avg lat 198 us 9,828 us 0.02x

8.4 顺序读写(1M block, iodepth=32, numjobs=1)

测试命令:fio --ioengine=libaio --direct=1 --bs=1m --iodepth=32 --numjobs=1 --rw=read/write --size=8G --runtime=30 --time_based

测试项 R670 NVMe 4214 RAID 倍数
Sequential Read 7,113 MB/s 2,366 MB/s 3.0x
Sequential Write 6,768 MB/s 302 MB/s 22.4x

8.5 混合随机读写(70/30, 4K, iodepth=32, numjobs=4)

测试命令:fio --ioengine=libaio --direct=1 --bs=4k --iodepth=32 --numjobs=4 --rw=randrw --rwmixread=70 --size=8G --runtime=30 --time_based

测试项 R670 NVMe 4214 RAID 倍数
Read IOPS 803,000 37,800 21.2x
Read avg lat 142 us 2,440 us 0.06x
Write IOPS 344,000 16,300 21.1x
Write avg lat 40 us 2,189 us 0.02x

8.6 磁盘配置与性能总结

项目 R670 (数据盘) 4214 (数据盘) sql-omni-tbhk 机型
设备类型 NVMe SSD (直通, 不走RAID) SAS/SATA SSD (RAID VD, 走RAID卡)
具体型号 Dell PM9D3a RI U.2 7.68TB 未知(RAID 控制器隐藏底层盘信息)
颗粒类型 TLC (Samsung V-NAND OEM) 未知
接口 NVMe PCIe (直连CPU) PERC H730P (SAS 12Gb/s, 2GB BBU cache)
定位 Read-Intensive 企业级 通用企业级
容量 7.68 TB ~1.8 TB (RAID VD)

性能对比总结(单队列延迟 = 数据库最关心的指标):

指标 R670 NVMe 4214 RAID SSD R670 优势 对 MySQL 的影响
4K 随机读延迟 64.6 us 101.3 us 1.6x data page 随机读
4K 随机写延迟 11.7 us 61.6 us* 5.3x redo log fsync
高并发随机读 IOPS 1,315K 70.9K 18.5x 高并发 OLTP
顺序写带宽 6,768 MB/s 302 MB/s 22.4x binlog / backup

*4214 写延迟受 RAID BBU 写缓存加速。从 IOPS 和延迟数据综合判断,4214 RAID 后面是 SSD(非 HDD),因为 HDD 4K 随机读只能做到 100-200 IOPS / 5-10ms 延迟,而 4214 实测 9,801 IOPS / 101us,这是 SSD 的特征。

关键差异来源:

  1. NVMe 直通 vs RAID 控制器:R670 的 NVMe 直连 CPU PCIe 总线,省去了 RAID 控制器的转发开销(~30-50us)
  2. PM9D3a 企业级 NVMe:三星 OEM 旗舰企业盘,内部并行度高(多 die 并发)
  3. 队列深度利用:NVMe 原生支持 64K 队列深度 × 64K 队列数,而 RAID 卡受限于控制器处理能力
  4. 写路径:NVMe 写直达闪存控制器(11.7us),RAID 卡写入 BBU 缓存后返回(61us,含 RAID 逻辑开销)

9. 综合对比总结

9.1 性能倍数一览

指标 R670 相对 4214 主要原因
单核 IPC 1.49x Granite Rapids 微架构
单核计算(7^999999) 1.89x IPC + 频率
单核 AES 吞吐 1.58x 频率 + AES-NI 优化
全核 AES 吞吐 2.88x 核数 + 单核性能
单核内存读带宽 1.78x DDR5 带宽
多核聚合内存带宽 3.0x DDR5 × 多通道
L3 容量 4.3x 72MB vs 16.9MB
内存绝对延迟 (@256MB) 0.88x (慢14%) DDR5 CAS latency 高
跨 NUMA 延迟惩罚 2.16x vs 1.62x UPI 距离 + snoop 开销
4K随机读 IOPS (高并发) 18.5x NVMe vs RAID
顺序读带宽 3.0x NVMe PCIe5 vs RAID
顺序写带宽 22.4x NVMe vs RAID BBU

9.2 结论

  1. CPU 计算能力:R670 单核比 4214 快 89%(IPC 2.72 vs 1.82 + 频率差),在所有历史测试 CPU 中单核性能最强
  2. 内存子系统:
    • 带宽:DDR5-6400 单核 1.78x,多核聚合 3.0x——多线程数据库场景的核心优势
    • 延迟:DDR5 绝对延迟更高(111ns vs 89ns)——但被 72MB L3 缓存弥补
    • 内存墙结论:R670 通过 “超大 L3 + 超高带宽” 两手策略应对内存墙,延迟敏感路径靠 L3,带宽敏感路径靠 DDR5 多通道
  3. 存储:NVMe 对 RAID 是降维打击,不在同一量级(18-50x 差距)
  4. NUMA:R670 跨 socket 惩罚(2.16x)比 4214(1.62x)更大,务必绑定 NUMA
  5. 适用场景:R670 极适合 MySQL 主库、Redis、低延迟中间件

9.3 内存墙假设验证总结

结论:假设成立但需要修正表述。

  • ✅ 带宽层面:DDR5-6400 确实是最大差异因素,提供 3x 聚合带宽,多线程 memory-bound 场景直接受益
  • ⚠️ 延迟层面:DDR5 延迟反而更高 14-25%(取决于 working set 大小)。但 R670 用 72MB L3(4.3x容量)把”内存墙”推后了——只有 working set > 72MB 才真正碰到 DDR5 的高延迟
  • ✅ 实际数据库效果:MySQL buffer pool 的 hot page 如果在 72MB 以内(非常多 OLTP 场景满足),R670 以 43ns L3 延迟服务,而 4214 在 17MB 就溢出到 89ns 内存——等效延迟 R670 反而快 35-50%

附录 A:R670 6517P 完整 lat_mem_rd 原始数据(-t 512M)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
Size(MB)   Latency(ns)
0.048 1.256 (L1d上限)
0.051 4.013 (L2起始)
0.250 4.202
1.000 5.769 (L2稳态)
2.000 15.974 (L3起始)
4.000 35.965
8.000 38.174
16.000 42.873
32.000 43.363
64.000 53.915 (L3尾部)
128.000 86.131 (Memory过渡)
256.000 102.399
512.000 111.135 (Memory稳态)

附录 B:4214 完整 lat_mem_rd 原始数据(-t 512M)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
Size(MB)   Latency(ns)
0.031 1.318 (L1d上限)
0.035 4.435 (L2起始)
0.250 6.754
1.000 11.785 (L2尾部/L3起始)
2.000 23.073 (L3稳态)
4.000 23.163
8.000 23.459
16.000 33.138 (L3边界16.9MB)
32.000 65.431 (Memory过渡)
64.000 77.831
128.000 84.381
256.000 87.439
512.000 89.133 (Memory稳态)

附录 C:历史 CPU 性能基准(来自 wiki 数据)

单核计算 7^999999

CPU 耗时(秒) IPC 主频 架构
R670 Xeon 6517P 11.35 2.72 3.2G Granite Rapids
Xeon 4214 21.46 1.82 2.2G Cascade Lake
Intel 710 15.83 2.64 2.75G (未知型号)
Intel 8269CY 18.60 2.19 2.5G Cascade Lake
鲲鹏920-4826 24.60 1.84 2.6G ARM v8
海光 C86 5280 26.73 0.92 2.5G Zen1 (AMD授权)
飞腾 FT2500 39.65 0.43 2.1G ARM v8

OpenSSL aes-256-cbc 单核 (8192B block)

CPU 吞吐 (KB/s) 主频
R670 Xeon 6517P 263,400 3.2G
Xeon 4214 166,530 2.2G
Intel 8269CY (52核) ~89,600 (参考) 2.5G
鲲鹏920 ~143,196 2.6G
海光 C86 5280 ~79,555 2.5G

历史 lat_mem_rd 内存延迟(local NUMA, @64MB -t 64M)

CPU Local Memory Latency (ns) 内存规格 L3 大小
R670 6517P 53.9* (@64MB仍在L3!) DDR5-6400 72MB
Intel 8269CY 69.8 DDR4-2666 36MB
Intel 8163 67.1 DDR4-2666 33.8MB
AMD EPYC 7T83 71.7 DDR4-3200 256MB(L3)
海光 7280 106.8 DDR4 128MB
海光 5280 102.6 DDR4 32MB
鲲鹏920 117.3 DDR4 48MB
飞腾2500 150.0 DDR4 64MB
申威3231 215.1 DDR4 64MB

*注:R670 在 @64MB 时数据仍在 72MB L3 缓存内,并非真实内存延迟。其真实内存延迟为 102-111ns (@256-512MB)。

https://www.servethehome.com/intel-xeon-6700p-and-6500p-granite-rapids-sp-for-the-masses-initial-benchmarks-and-first-look/4/

开源代码加个壳,年收你 15 万美金——一次 RDS 迁移自建的成本审计

一句话结论

我们把 6 个 RDS MySQL 集群迁到 EC2 自建,年省 $151,425(76%)。这不是什么黑科技,就是把云厂商帮你装好的 MySQL 自己装了一遍。


云数据库的定价逻辑

RDS 的本质是:在 EC2 上跑一个开源数据库,加一层管控面板,然后把价格翻一倍往外卖。

以 ap-east-1 区域 db.m5d.xlarge(4C 16G)为例:

部署方式 小时单价 倍率
EC2 同配置裸机 $0.277/hr 1×
RDS Single-AZ $0.638/hr 2.3×
RDS Multi-AZ(2 节点) $1.276/hr 4.6×
RDS Multi-AZ DB Cluster(3 节点) $1.768/hr 6.4×

存储更离谱。同样的 gp3 磁盘:

EBS 直接挂载 RDS 存储(3 节点集群) 倍率
容量 $0.1056/GB-month $0.45/GB-month 4.3×
IOPS(超基线) $0.0066/IOPS-month $0.078/IOPS-month 11.8×
吞吐(超基线) $0.0528/MiBps-month $0.313/MiBps-month 5.9×

你没看错——同一块硬盘、同一个 IOPS,挂在 RDS 上比挂在 EC2 上贵 12 倍。

那管控面板值这个差价吗?


管控做了什么:收钱的自动化

RDS 管控提供的核心能力:

  1. 自动备份 —— 一个 cron + mysqldump/xtrabackup 的事
  2. 自动故障切换 —— 开源社区 orchestrator/MHA 免费且更灵活
  3. 自动小版本升级 —— 这不是优点,这是灾难(下面细说)
  4. 监控 —— Performance Insights 还要额外收费,基础 CloudWatch 指标连 QPS 都看不到
  5. 参数管理 —— 一个 my.cnf 的事,还不让你改一半参数

真正恶心的是强制升级。

MySQL 8.0 社区还在维护,RDS 直接宣布 EOL,逼你升 8.4。理由?”降低我们的运维成本”。从来不考虑:

  • 你的 ORM 框架兼不兼容
  • 你的 CDC 组件(Canal/Debezium)测过没有
  • 你的 SQL 在新优化器下会不会回退

云厂商嘴上说”客户第一”,实际做的每一个决策都是”降低自己的运维成本,把风险转嫁给客户”。一个 Terraform apply 就把你几百个集群的引擎版本全换了,你连说不的机会都没有。


实战:6 个集群的迁移账本

原始配置

# RDS 规格 节点数 存储 IOPS 月费
1 db.m5d.4xlarge (16C 64G) 3 500GB gp3 12,000 $6,208
2 db.m5d.2xlarge (8C 32G) 3 500GB gp3 12,000 $3,626
3 db.m5d.2xlarge (8C 32G) 3 500GB gp3 12,000 $3,626
4 db.m5d.xlarge (4C 16G) 3 400GB gp3 12,000 $2,290
5 db.m5d.large (2C 8G) 3 200GB gp3 3,000 $735
6 db.t3.small (2C 2G) 2 100GB gp2 — $114
合计 $16,598/月

迁移后实际 EC2 配置

# EC2 规格 节点数 存储 IOPS 月费
1 m7i.xlarge (4C 16G) 3 350GB gp3 3,000 $734
2 m6i.2xlarge (8C 32G) 3 350GB gp3 3,000 $1,283
3 r6i.xlarge (4C 32G) 3 350GB gp3 3,000 $858
4 m7i.xlarge (4C 16G) 3 350GB gp3 3,000 $734
5 c7i.large (2C 4G) 3 100GB gp3 3,000 $296
6 规划 t3.small 2 100GB gp3 3,000 $74
合计 $3,979/月

成本分析

RDS 年费:$199,174
EC2 年费:$47,749
年省:$151,425(76%)


省钱的三个层次

第一层:平移替换(省 50-60%)

单纯把 RDS 换成同规格 EC2 自建 MySQL,不做任何优化。省钱来源:

  • 去掉 RDS 的”管控溢价”(计算 2-3 倍)
  • 去掉存储的”托管溢价”(IOPS 12 倍)
  • 使用 gp3 基线 3000 IOPS 免费额度(RDS 要额外收钱)

第二层:基于监控降配(再省 15-20%)

拉取 48 小时监控后发现:

集群 CPU Avg 存储 IOPS 实际使用 配置 IOPS 利用率
集群 1(16C 64G) 2.5% 20 12,000 0.17%
集群 5(2C 8G) 17.5% 0.7 3,000 0.02%
集群 6(2C 2G) 4.3% 0.8 — —

集群 1 尤其荒唐:RDS 上跑着 16C 64G 的大实例,实际 CPU 平均 2.5%,存储 IOPS 日常仅 20。我们直接降到 4C 16G,一个集群就省了 $65,687/年。

这不是什么高难度操作——拉个 CloudWatch 指标谁都会。但如果你用着 RDS,你永远不会去想”我要不要降配”,因为:

  1. RDS 没有直观的利用率告警(连 QPS 都不给你看,要开 Performance Insights 再付钱)
  2. 修改实例规格需要重启,Multi-AZ 切换有风险
  3. 反正不是自己的钱,KPI 不考核基础设施成本

第三层:总结

层次 动作 节省比例
平移替换 RDS → EC2 同规格 50-60%
监控降配 基于实际负载缩减规格 +15-20%
合计 ~76%

这只是冰山一角

上面 6 个集群的 RDS 年费不到 20 万美金。在我们整个基础设施账单里,这连 5% 都不到。

如果把所有托管服务(RDS、ElastiCache、MSK、OpenSearch……)全部迁移自建,按同样的比例估算,年省百万美金量级不是梦话。

而在国内互联网行业,很多公司一年在云上花几千万甚至几个亿人民币。按我们实测的 76% 节省比例,实际可能只需要 20-30% 的预算就能跑同样的业务。剩下的钱去哪了?去了云厂商的毛利率报表里。


更进一步:EC2 到 IDC 自建

如果 RDS 到 EC2 能省 76%,那 EC2 到自建 IDC 呢?

EC2 本身也有”云溢价”。同样一台 4C 16G 的服务器:

方案 月成本估算 相对 EC2
EC2 On-Demand $202/月 1×
EC2 1年 Savings Plan $140/月 0.7×
IDC 自建(含托管+带宽+折旧) $60-80/月 0.3-0.4×

经验法则:当你的年云支出超过 1000 万人民币(约 $140 万美金),就应该认真评估自建 IDC 或混合架构了。在这个规模下:

  • 你已经有足够的运维团队
  • 服务器采购有议价空间
  • 网络带宽成本可以通过 BGP 直连大幅降低
  • 3 年折旧后硬件几乎是”免费”的

工程师的价值

$151,425/年。

这是一个 DBA 花两周时间做迁移评估 + 执行带来的年化收益。这笔钱:

  • 在北京够招一个资深工程师
  • 在二线城市够招两个
  • 比 90% 的”降本增效”项目 ROI 都高

而且这还只是”小试牛刀”——6 个中小规格集群。

别忘了,这原本 20 万刀的开支上面,云厂商还要再收 8% 的企业支持服务费(Enterprise Support)。$199,174 × 8% = $15,934/年,又是一个工程师的工资。

放大到整个公司:如果你一年在云上花 1000 万人民币,8% 就是 80 万——够养一个 3-4 人的专职运维团队了。而云厂商的”支持服务”给你什么?一个工单系统、一个响应 SLA、偶尔帮你提个 limit。你自己的工程师调个参数 5 分钟搞定的事,走工单要等 24 小时。

如果你是多云架构,情况更糟:

  • 每家云都要交一份支持费
  • 每家的 API/控制台/计费模型都不一样,运维工具要写多套
  • 跨云网络打通本身就是成本(专线、VPN、流量费)
  • 出了问题两家互相甩锅,你夹在中间当传话筒

如果你已经有了 IDC 自建能力,云上的托管服务就是在给云厂商交智商税。 同样的 MySQL、同样的 Redis、同样的 Kafka——跑在你自己机房的服务器上,性能更好、延迟更低、成本是云上的 1/5。

云厂商的销售会告诉你”自建运维成本高””要招人要管理”。但他们不会告诉你:

  • 他们的托管服务本身就是你花钱让别人招了个运维
  • 这个运维收费是市场价的 5-10 倍
  • 这个运维还会强制你升级、限制你改配置、监控还要额外付费
  • 你交的 8% 支持费,换来的是一个工单系统和一句”建议您升级到最新版本”

AI 才是真正的降本增效工具

很多人问:自建听起来好,但你哪来的人力做迁移评估、写管控脚本、搞高可用切换?

答案是:AI。

这次 6 个集群的迁移评估,从拉取 RDS 配置、查询 CMDB 元数据、获取 EC2 实际规格、抓取 AWS 官方定价 JSON、计算成本对比、生成汇总报告——全程由 AI Agent 完成。一个 DBA 坐在终端前给指令,AI 负责执行。整个成本审计过程不到 2 小时。

传统做法?开会讨论 → 安排人力 → 写脚本拉数据 → Excel 算半天 → 做 PPT 汇报 → 领导审批。一个月能出结果算快的。

AI 在这次迁移中具体干了什么

环节 AI 完成的工作 替代的传统人力
配置审计 批量调用 AWS CLI 拉取 6 个集群的 RDS/EC2 规格、存储、IOPS 运维工程师手动登录控制台逐个记录
价格计算 从 AWS Bulk Pricing JSON(几百 MB)中精确提取区域定价 打开 N 个定价页面手动比对
CMDB 关联 SSH 跳板机查询内部元数据库,关联 RDS 与 EC2 实例 运维人员人肉翻 CMDB
监控分析 批量拉 CloudWatch 48h 数据,识别降配机会 人工看图、拍脑袋
报告生成 直接输出结构化 Markdown/飞书文档 写 Word、排版、发邮件
迁移工具 生成数据校验脚本、切换 checklist、回滚方案 高级 DBA 手写

为什么很多公司 AI “烧 token 看不到效果”

每月花几万块 token 费,产出是什么?让员工用 ChatGPT 润色周报、用 Copilot 补全几行代码、开会用 AI 做纪要。这些场景有价值吗?有。但 ROI 约等于零——因为省的是”5 分钟”,不是”5 万美金”。

AI 降本增效的正确姿势:让 AI 去做那些”能做但没人力做”的事。

成本审计就是典型。每个公司都知道云上可能有浪费,但:

  • 没人有空去逐个实例拉监控
  • 没人愿意花一周时间算 Excel
  • 算完了还不一定能推动执行

AI 把这个成本降到接近零。一次对话 = 一次完整审计 = 发现 $15 万/年的节省机会。 这次对话消耗的 token 费?不到 $5。

ROI 对比

场景 投入 年化产出 ROI
AI 润色周报/邮件 $100/月 token 省 10 小时人力 ≈ $500 5×
AI 辅助写代码 $200/月 token 省 20% 开发时间 ≈ $2,000 10×
AI 做基础设施成本审计 $5 token $151,425/年 30,000×

差距不是 AI 本身的问题,是你让 AI 做什么的问题。

让 AI 帮你写”尊敬的领导,现将本周工作汇报如下”——这不叫降本增效,这叫浪费电。让 AI 帮你查明白每年有 15 万美金在被云厂商白拿——这才叫降本增效。

给管理者的建议

  1. 别让 AI 去做”锦上添花”的事,让它去做”本来没人力做”的事
  2. 基础设施成本审计是最容易落地的高 ROI 场景——数据结构化、API 可调用、结果可量化
  3. 把 AI 当成一个 7×24 的初级运维,给它明确的指令和工具权限,它能干的活比你想象的多
  4. 衡量 AI 投入的标准不是”省了多少时间”,而是”做了多少原来做不了的事”

结语

云厂商不是做慈善的。RDS 的商业模式就是:

把 MySQL 官网免费下载的二进制文件装到你本来就在付费的 EC2 上,加一个 Web 控制台,然后跟你收 2-12 倍的溢价。

这门生意的毛利率,做梦都能笑醒。

而你只需要一个懂 MySQL 的工程师、一套开源高可用方案(orchestrator + ProxySQL)、一个备份脚本——就能省下 75% 的钱,还能获得更大的灵活性。

不是所有上云都是降本。绝大多时候,下云才是。

云计算极致弹性的骗局

一句话总结

云厂商卖的是”随时扩容、秒级弹性”,实际交付的是”库存看运气、升配等半天、换代要验证、出了问题没人兜底”。

今天发生了什么

我们的内部某个系统需要紧急扩容。业务处于重保状态,绝对不能出问题。

结果呢?在阿里云上升配一台 ECS,花了超过 5 个小时,到现在还没搞定。

原因:

  • 7 代机库存不足,扩不上去
  • 9 代机有库存,但不让从 7 代直接升——AMD/Intel 架构差异、机器代数差异等”稳定性考量”不允许跨代升配
  • 资源明明有,但就是用不上

这就是云厂商口中的”极致弹性”。

弹性的真相:一张限制清单

云厂商的宣传:需要资源?点一下,秒级到位。

实际情况:

你以为的 实际的
随时扩容 老代际没库存,扩不动
秒级弹性 升配排队 5 小时起步
按需付费 想用新代际?先全量迁移+验证
免运维 云厂商改默认参数不通知你,出了问题你自己查

升级坑死你的案例:https://plantegg.github.io/2026/04/15/AWS-HikariCP-%E8%BF%9E%E6%8E%A5%E8%B6%85%E6%97%B6%E6%A0%B9%E5%9B%A0%E5%88%86%E6%9E%90/

更讽刺的是——今天有库存不代表明天有。库存是动态的,哪天一个大客户扫一波资源,你原来能扩的机型就扩不动了。

换代验证:花钱替云厂商做测试

云厂商每隔两三年推出新一代实例。旧代际的库存会逐渐减少。为了保证未来能弹性扩容,你就得主动迁移到新代际。

迁移意味着什么?

  1. 新旧代际的默认参数可能不一致
  2. 你要停下业务开发,专门去做兼容性验证
  3. 验证过了,也不能保证不漏——因为有些差异只在特定场景才暴露

这不是假设,是真实踩过的坑:

AWS 第 8 代 EC2 实例(2025 年 9 月上线),把 ENI 安全组的连接跟踪超时从 5 天(432000 秒)悄悄改成了 350 秒。没有独立公告,没有迁移指南,甚至 API 在 6 个月后才开始返回这个参数:https://plantegg.github.io/2026/04/15/AWS-HikariCP-%E8%BF%9E%E6%8E%A5%E8%B6%85%E6%97%B6%E6%A0%B9%E5%9B%A0%E5%88%86%E6%9E%90/

后果:所有跨网络的长连接(数据库、消息队列、RPC),只要空闲超过 350 秒,就会被安全组静默丢弃——不发 RST,不通知任何一方。应用端看到的就是”莫名超时”。我们的 Java 服务迁移到 AWS 8 代实例后,HikariCP 连接池每隔 20 分钟就批量报错。

排查花了多久? 从开 case 到定位根因,19 小时。AWS 自己的支持工程师都要开两轮会议才找到原因。而 AWS 确认,已有 6 家大型企业、10 余个支持案例报告了同一问题——实际受影响的用户远不止这些,因为”静默丢包”根本不会产生明确的错误信号。

这就是你要做的”换代验证”——替云厂商测试他们自己都没文档化的行为变更。

自建机房为什么不需要这种验证

“买新物理机不也要验证吗?”——不需要,或者说简单到可以忽略。

原因很直接:

物理机是干净的。 一台戴尔/联想的服务器,装完 OS 就能用。服务器厂商在出厂前已经做过 OS 兼容性测试。你的业务直接跑在裸金属上,中间没有任何隐藏层。

ECS/EC2 不是干净的。 云厂商在你的 VM 和物理硬件之间塞了一堆自己的服务:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
你以为的结构:          实际的结构:

┌─────────────┐ ┌─────────────┐
│ 你的应用 │ │ 你的应用 │
├─────────────┤ ├─────────────┤
│ OS │ │ OS │
├─────────────┤ ├─────────────┤
│ 硬件 │ │ 虚拟化层 │ ← 你看不到、控制不了
└─────────────┘ ├─────────────┤
│ ENI 连接跟踪│ ← 默认参数随代际变
├─────────────┤
│ 云盘 IO 调度│ ← 性能特征随代际变
├─────────────┤
│ 管控面代理 │ ← 占 CPU/内存
├─────────────┤
│ Nitro/神龙卡│ ← 固件行为不透明
├─────────────┤
│ 物理硬件 │
└─────────────┘

每换一代实例,这些隐藏层的行为都可能变化。而且云厂商不会事先告诉你变了什么——因为这些是他们的”内部实现细节”。

物理机换代: 装 OS → 简单压测 → 上线。一个运维花半天搞定。不需要惊动业务研发。

ECS 换代: 申请新代际实例 → 部署全套应用 → 回归测试 → 性能对比 → 连接行为验证 → 灰度切流 → 观察一周。一个团队花两周,业务研发全部停下来配合。

你花钱买了”弹性”,结果每两年要停下来做一次全量迁移验证。这不是弹性,这是供着一个祖宗。

库存问题无解

有人说:”跟云厂商提前报备,让他们预留库存。”

想想这意味着什么:

  • 你要提前规划未来的扩容需求(那还要弹性干什么?)
  • 你要信任云厂商的库存承诺(今天有库存明天就没了)
  • 你要绑定特定代际(否则哪天被迫换代又要全量验证)

按需、弹性、免规划——卖点一个都兑现不了。

结论

云计算的”极致弹性”是一个营销概念,不是工程事实。

真实的云计算体验是:

  • 扩容要看库存脸色——紧急时刻扩不动
  • 换代要做全量验证——业务研发替云厂商测试
  • 默认参数会变——不通知、不文档化、出了问题你自己查
  • 中间层行为不透明——静默丢包连错误信号都没有

如果你的业务对可用性有要求,在做架构决策时,请把这些成本算进去。不要被”秒级弹性”的 PPT 忽悠了。

5 个小时了,我只是想给一台 ECS 加点配置而已。

JVM DNS 缓存 TTL 配置避坑指南(实验验证版)

适用范围:所有 Java 业务,尤其在用域名而非 IP 接入下游服务(数据库、Kafka、Redis、HTTP 服务等)的场景。
验证环境:OpenJDK 17(Rocky Linux 8.10);结论同样适用 Java 8/11/21。
验证日期:2026-05-25。

TL;DR(先看这部分)

如果你只想拿走一条结论:

-Dnetworkaddress.cache.ttl=N 是错的,不会生效。

想用 JVM 启动参数控制 DNS 缓存 TTL,只有 -Dsun.net.inetaddr.ttl=N 这一种正确写法。

如果还能拿走第二条:

代码里 Security.setProperty("networkaddress.cache.ttl", "N") 极易被 log4j2、Spring、Kafka client 等抢跑而失效。生产配置不要依赖这种方式。

如果还能拿走第三条:

推荐配置(任选其一,不用全选):

  1. 启动参数:-Dsun.net.inetaddr.ttl=30 -Dsun.net.inetaddr.negative.ttl=10
  2. 或修改 $JAVA_HOME/conf/security/java.security 里 networkaddress.cache.ttl=30、networkaddress.cache.negative.ttl=10

下面是 11 组对照实验的证据。


1. 背景:两个属性、两套存储、一个静态字段

1.1 控制 JVM DNS 缓存 TTL 的两个属性

属性名 类别 设置途径 备注
networkaddress.cache.ttl Security property 代码 Security.setProperty(...);$JAVA_HOME/conf/security/java.security 文件 Java 1.4+ 官方正名
sun.net.inetaddr.ttl System property 代码 System.setProperty(...);JVM 启动参数 -D Sun 私有的旧名,作为 fallback 保留

负向缓存对应 networkaddress.cache.negative.ttl / sun.net.inetaddr.negative.ttl。

1.2 JDK 内部的读取逻辑(OpenJDK 17 源码 sun.net.InetAddressCachePolicy)

1
2
3
4
5
6
7
8
9
10
11
12
13
14
public final class InetAddressCachePolicy {
private static volatile int cachePolicy; // ← 真正起作用的值

static { // ← 类首次加载时执行 1 次,之后再不读取
Integer tmp = AccessController.doPrivileged(...) {
// 1) 优先读 Security.getProperty("networkaddress.cache.ttl")
// 2) fallback 读 System.getProperty("sun.net.inetaddr.ttl")
};
cachePolicy = (tmp != null) ? tmp
: (hasSecurityManager ? FOREVER : 30); // 默认 30s
}

public static int get() { return cachePolicy; }
}

三个关键事实:

  1. 静态块只跑一次(class load 时),之后不再读 Security/System property。
  2. 所以业务代码里再调 Security.setProperty(...) 改 TTL,InetAddressCachePolicy 不会回头读——值已经被冻在 cachePolicy 字段里了。
  3. JVM 内部 System Properties 与 Security Properties 是两套独立存储:
    • -Dnetworkaddress.cache.ttl=N 写进的是 System Properties
    • 但 InetAddressCachePolicy 第一步走 Security.getProperty(...),根本不读 System Properties
    • 所以这种写法虽然不报错,但完全没有效果

1.3 默认值

  • 无 SecurityManager(绝大多数现代生产场景):正向 30 秒,负向 10 秒
  • 有 SecurityManager(极少见):正向 forever(永久),负向 10 秒

2. 实验设计

2.1 待验证的核心假设

任何在你 Security.setProperty(...) 之前调用 InetAddress.getXxxByName() / getLocalHost() 的代码,都会触发 InetAddressCachePolicy 类首次加载,使 cachePolicy 字段被冻结到 JVM 默认值。其中最常见的抢跑者就是 log4j2 的 LogManager.getLogger(...)——尤其是写在 static final 字段里的那种。

2.2 测量方法(双重证据)

  • 直接证据:反射读取 sun.net.InetAddressCachePolicy.get() 拿到 effective 值
  • 间接证据:tcpdump 抓 udp dst port 53 包,统计 20 秒内对目标域名的实际 DNS 查询次数
    • 若 TTL=2 生效:约 20+ 次(每秒一查,缓存基本不命中)
    • 若 TTL 失效(默认 30s):约 4~6 次(启动 overhead + 全程命中缓存)
    • 差异 4~6 倍,结论稳定

2.3 11 个对照场景

# TTL 设置方式 log4j Logger 时机
S1 -Dnetworkaddress.cache.ttl=2 不引入 log4j(基线)
S2 代码 Security.setProperty(main 首行) 不引入 log4j(基线)
S3 代码 setProperty(main 首行) setProperty 之后再 LogManager.getLogger
S4 代码 setProperty static final Logger 字段(类加载即触发,生产里最常见的写法)
S5 代码 setProperty main 中先 LogManager.getLogger 后 setProperty(手写错顺序)
S6 -Dnetworkaddress.cache.ttl=2 static final Logger 字段
S7 -Dsun.net.inetaddr.ttl=2 不引入 log4j
S8 -Dsun.net.inetaddr.ttl=2 static final Logger 字段(验证 -D 能否兜底)
S9 -Dsun.net.inetaddr.ttl=2 main 中先 getLogger 后 setProperty
S10 java.security 文件 networkaddress.cache.ttl=2 不引入 log4j
S11 java.security 文件 networkaddress.cache.ttl=2 static final Logger 字段(验证文件能否兜底)

3. 实验结果

# TTL 设置方式 log4j Logger 时机 DNS 查询数 cachePolicy TTL 生效
S1 -Dnetworkaddress.cache.ttl=2 无 6 30 ❌
S2 代码 Security.setProperty 无 26 2 ✅
S3 代码 setProperty setProperty 后 getLogger 26 2 ✅
S4 代码 setProperty static final 字段 4 30 ❌
S5 代码 setProperty main 中 getLogger 先于 setProperty 4 30 ❌
S6 -Dnetworkaddress.cache.ttl=2 static final 字段 6 30 ❌
S7 -Dsun.net.inetaddr.ttl=2 无 26 2 ✅
S8 -Dsun.net.inetaddr.ttl=2 static final 字段 26 2 ✅
S9 -Dsun.net.inetaddr.ttl=2 main 中 getLogger 先 24 2 ✅
S10 java.security 文件 无 26 2 ✅
S11 java.security 文件 static final 字段 26 2 ✅

TTL=2,每秒解析一次共 20 次。生效时 cachePolicy=2、DNS 查询数 ≈ 20+;失效时 cachePolicy=30、查询数 ≈ 46(这 46 次是 JVM 启动期 hostname/reverse-lookup 等开销,业务期完全命中缓存)。

3.1 四种主流设置方式的最终判定

设置方式 验证场景 判定
-Dnetworkaddress.cache.ttl=N S1, S6 ❌ 完全无效(写错 property store)
代码 Security.setProperty(...) S2, S3 / S4, S5 ⚠️ 理论可行,实际极易被抢跑
-Dsun.net.inetaddr.ttl=N S7, S8, S9 ✅ 稳定生效,能兜底任意代码顺序
java.security 文件 networkaddress.cache.ttl=N S10, S11 ✅ 稳定生效,能兜底任意代码顺序

4. 为什么 log4j2 会”覆盖”你的设置(机制澄清)

严格说不是覆盖,是读取时机错过。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
时间轴(坏写法 S4):

t0 类加载 MyClass(业务的 main 类)
t0a → static final Logger LOG = LogManager.getLogger(MyClass.class); ← 类加载阶段
t0b → log4j2 LoggerContext init
t0c → 解析配置 / 注册 ServiceLoader / hostname lookup
t0d → 第一次调到 InetAddress.getXxxByName()
t0e → 触发 InetAddressCachePolicy.<clinit>
t0f → Security.getProperty("networkaddress.cache.ttl") = null
t0g → System.getProperty("sun.net.inetaddr.ttl") = null
t0h → 用默认值 30,写入 cachePolicy 字段,**永久冻结**

t1 main() 进入
t1a Security.setProperty("networkaddress.cache.ttl", "5");
↑ 写进了 Security Properties Map,但 cachePolicy 字段不再被读
t1b 之后所有 InetAddress 操作 → InetAddressCachePolicy.get() → 30

4.1 抢跑者远不止 log4j2

任何在 Security.setProperty 之前触发 InetAddress.getXxxByName/getLocalHost 的代码,都会冻结 cachePolicy。常见的有:

抢跑者 触发路径
log4j2 / logback LogManager.getLogger() 初始化 LoggerContext,配置里 ${hostName}/%H 或某些默认 Lookup 触发
java.util.logging (JUL) LogRecord 默认携带 hostname
Spring Boot 启动 banner、Actuator、InetUtils 自动选 IP
Tomcat / Jetty / Netty bind() 时解析监听地址;Netty 还会初始化 DNS resolver
Kafka client KafkaProducer/Consumer 构造时 ClientUtils.parseAndValidateAddresses 解析 bootstrap 域名
HikariCP / Druid 等连接池 初始化时连第一个 DB 实例(解析 JDBC URL host)
JMX / RuntimeMXBean getRuntimeMXBean().getName() 拼 pid@hostname,触发 reverse lookup
Micrometer / Prometheus 注册 metrics 时打 hostname tag
Apache HttpClient / OkHttp client 构造时可能预解析
Java agent (-javaagent) APM agent (Skywalking、Pinpoint、NewRelic、DataDog) 在 premain() 阶段就跑,早于 main,常自报 hostname——这条最阴险,业务代码完全没写错,agent 默默把你的 setProperty 干掉了

只要这个清单里任意一项先于业务代码 Security.setProperty,TTL 就被冻在默认值。


5. 业务方避坑清单(必读)

5.1 必须避免

❌ 错误写法 错误原因
-Dnetworkaddress.cache.ttl=30 写进了 System Properties,但 InetAddressCachePolicy 只从 Security Properties 读这个名字。完全无效。
Security.setProperty(...) 写在 static {} 块或字段初始化里 与其他 static 初始化的执行顺序不可控,几乎注定被 log4j 抢跑
把 setProperty 放在某个工具类的 init 方法里、依赖被调用一次 同上,时机不可控
只设正向、不设负向 默认负向 10 秒(部分 Linux 发行版打包甚至改过这个值);DNS 失败的负向缓存仍然影响故障切换

5.2 推荐做法(任选其一)

方案 A:JVM 启动参数(最方便、最不容易出错)

1
2
3
java -Dsun.net.inetaddr.ttl=30 \
-Dsun.net.inetaddr.negative.ttl=10 \
-jar app.jar

适用场景:业务团队普遍写 java.security 文件不方便,或者运维平台/发布系统能统一注入 JVM 参数。

方案 B:修改 java.security 配置文件(系统级、所有 Java 进程统一生效)

编辑 $JAVA_HOME/conf/security/java.security(Java 8 是 $JAVA_HOME/jre/lib/security/java.security):

1
2
networkaddress.cache.ttl=30
networkaddress.cache.negative.ttl=10

注意:

  • 该文件可能本来就有这两行,要么注释掉、要么是默认值。不要新增重复行。
  • 修改后所有运行该 JDK 的进程都会生效,改之前确认无副作用。
  • RPM 装的 JDK 在升级时会用包里的版本覆盖该文件,升级流程要带回这个修改。
  • 实测发现 RHEL/Rocky 默认就有 networkaddress.cache.negative.ttl=10 这行(不是 JDK 默认 0),删它会改变行为。

方案 C:代码内 Security.setProperty(...) —— 不推荐

如果实在因为某些原因要用代码方式设置:

1
2
3
4
5
6
public static void main(String[] args) {
// 必须是 main 第一行(甚至要早于该类的 static field 初始化,但 static field 在 main 之前已执行)
Security.setProperty("networkaddress.cache.ttl", "30");
Security.setProperty("networkaddress.cache.negative.ttl", "10");
// ……
}

且必须确保这个 main 类不持有任何 static final Logger 字段——否则 log4j 在类加载期就跑完了。

但即便这样,仍然防不住 -javaagent 在 premain 阶段抢跑。所以代码方式只在简单场景下能用,在带 APM agent 的环境里基本必败。

5.3 取值建议

场景 正向 TTL 负向 TTL
一般业务 30 秒 10 秒
频繁 DNS 切换/扩缩容 10 ~ 30 秒 5 ~ 10 秒
DNS 极少变更、追求性能 60 ~ 300 秒 30 秒
永远不要 -1(永久缓存)—— 这是带 SecurityManager 时的默认值,DNS 一变就再也感知不到 0 也要慎用——DNS 失败时会变成每次解析打 DNS server,可能造成查询风暴

6. 验证与诊断

6.1 一行命令验证 TTL 是否生效

1
2
3
4
5
# 替换 -Dsun.net.inetaddr.ttl=2 为你实际的写法,看打印是不是 2
java -Dsun.net.inetaddr.ttl=2 \
--add-opens java.base/sun.net=ALL-UNNAMED \
-e 'System.out.println(((Integer)Class.forName("sun.net.InetAddressCachePolicy").getMethod("get").invoke(null)));' \
2>/dev/null

或者写一个最简验证类:

1
2
3
4
5
6
7
8
public class TtlCheck {
public static void main(String[] args) throws Exception {
java.lang.reflect.Method m = Class.forName("sun.net.InetAddressCachePolicy")
.getMethod("get");
m.setAccessible(true);
System.out.println("Effective TTL = " + m.invoke(null) + " seconds");
}
}

运行:java --add-opens java.base/sun.net=ALL-UNNAMED TtlCheck

期望输出:Effective TTL = 30 seconds(或你设置的值);如果是其他奇怪值就有问题。

6.2 定位是谁在抢跑(深度排查)

1
java -Xlog:class+init=info ...your-app... 2>&1 | grep -E 'InetAddressCachePolicy|InetAddress\$'

能看到 InetAddressCachePolicy 在哪个时点、被哪个类引用首次初始化。结合 -XX:+TraceClassLoading 或在该类静态块挂断点能看到完整调用栈。

6.3 用 tcpdump 验证业务运行期的 DNS 查询频次

1
2
3
4
# 在业务实例上抓 30 秒
sudo tcpdump -i any -nn 'udp port 53' -w /tmp/dns.pcap &
sleep 30 ; sudo killall tcpdump
sudo tcpdump -nn -r /tmp/dns.pcap | grep '<your-domain>' | wc -l

把这个数字除以 30 得到每秒查询频次。如果查询频次 << 1/TTL,说明 TTL 比预期大;如果 ≈ 业务每秒解析次数,说明缓存几乎不命中。


7. 附录

7.1 实验脚本与原始日志

  • 实验目录:~/q/tmp/jvm-dns-ttl-log4j-test/(本地)/ /root/jvm-dns-ttl-log4j-test/(测试机 172.30.65.103)
  • 主程序:TtlProbe.java
  • 跑 S1~S9:bash run-experiment.sh
  • 跑 S10/S11:bash run-jsec-experiment.sh(自动备份/还原 java.security)
  • 原始 pcap + log:results/

7.2 历史背景:为什么 JVM 有”两个名字”

  • JDK 1.4 之前:只有 sun.net.inetaddr.ttl,Sun 私有 system property
  • JDK 1.4(2002 年):把 DNS 缓存策略正式化到 Security property 标准里,引入 networkaddress.cache.ttl 作为官方名
  • 此后至今:旧名 sun.net.inetaddr.ttl 没废弃,作为 fallback 保留——保兼容

设计层面的内在矛盾:官方名是 Security property,但 JVM 最方便的设置方式(-D)只能设 System property。绝大多数业务方踩坑,根源就是直觉地把这两者拼成 -Dnetworkaddress.cache.ttl=N,然后悄悄失效。

7.3 相关资源

7.4 验证环境

  • OS:Rocky Linux 8.10
  • JDK:OpenJDK 17.0.19(Red_Hat-17.0.19.0.10-1)
  • log4j2:2.20.0
  • 测试域名:3 条 A 记录的内网域名
  • 验证日期:2026-05-25

MySQL PreparedStatement 性能问题重现报告

1. 问题概述

1.1 问题描述

在 MySQL 使用 useServerPrepStmts=true 时,处理大量参数(5万个)的 PreparedStatement IN 查询时存在严重性能问题。根据原始报告,服务器端预编译比客户端预编译慢 190-207倍。

1.2 问题来源

1.3 问题根因(原始报告)

MySQL 服务器在处理大量参数的 PreparedStatement 时:

  1. 大量内存重分配: 50,000 次参数替换操作
  2. 字符串操作复杂度: O(SQL长度) × 参数数量
  3. 内存碎片化: 频繁的大块内存分配和释放

2. 测试环境

2.1 AWS 资源信息

资源 配置
AWS Account 872515255872
Region ap-southeast-1
VPC vpc-084114e405054a5b7

2.2 RDS MySQL 8.0 实例

配置项 值
实例标识符 mysql-prepared-test
实例类型 db.t3.medium (2vCPU, 4GB)
存储 50GB gp3
引擎版本 MySQL 8.0.43
Endpoint mysql-prepared-test.cfsoq6muu0jv.ap-southeast-1.rds.amazonaws.com

2.3 RDS MySQL 5.7 实例

配置项 值
实例标识符 mysql57-prepared-test
实例类型 db.t3.medium (2vCPU, 4GB)
存储 50GB gp3
引擎版本 MySQL 5.7.44-rds.20240408
Endpoint mysql57-prepared-test.cfsoq6muu0jv.ap-southeast-1.rds.amazonaws.com

2.4 EC2 测试客户端

配置项 值
实例 ID i-0b26f3cb781bae059
实例类型 t3.medium
AMI Amazon Linux 2023
Public IP 18.141.185.36
Java Amazon Corretto 17
Maven 3.8.4

3. 测试方法

3.1 测试代码

1
2
3
4
git clone https://github.com/plantegg/MySQLPrepared.git
cd MySQLPrepared
./run_test.sh --host <mysql-host> --port 3306 --database test \
--user admin --password '<password>' --rounds 3

3.2 测试参数

参数 值
IN 查询参数数量 50,000
参数类型 15位大整数
SQL 长度 (spaces=128) ~6.5MB
测试轮次 3

3.3 AWS CLI 命令

创建 RDS MySQL 8.0 实例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
aws rds create-db-instance \
--profile default --region ap-southeast-1 \
--db-instance-identifier mysql-prepared-test \
--db-instance-class db.t3.medium \
--engine mysql \
--engine-version 8.0 \
--master-username admin \
--master-user-password 'Tiger#2612' \
--allocated-storage 50 \
--storage-type gp3 \
--db-subnet-group-name mysql-benchmark-subnet-group \
--vpc-security-group-ids sg-01541b078e0b483d0 \
--no-multi-az \
--publicly-accessible \
--backup-retention-period 0 \
--no-auto-minor-version-upgrade

创建 RDS MySQL 5.7 实例

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
aws rds create-db-instance \
--profile default --region ap-southeast-1 \
--db-instance-identifier mysql57-prepared-test \
--db-instance-class db.t3.medium \
--engine mysql \
--engine-version 5.7.44-rds.20240408 \
--master-username admin \
--master-user-password 'Tiger#2612' \
--allocated-storage 50 \
--storage-type gp3 \
--db-subnet-group-name mysql-benchmark-subnet-group \
--vpc-security-group-ids sg-01541b078e0b483d0 \
--no-multi-az \
--publicly-accessible \
--backup-retention-period 0 \
--no-auto-minor-version-upgrade

创建 EC2 测试实例

1
2
3
4
5
6
7
8
aws ec2 run-instances \
--profile default --region ap-southeast-1 \
--image-id ami-0d1c0ec9903f7b01f \
--instance-type t3.medium \
--key-name renxijun-ec2-key \
--security-group-ids sg-0706d5fbe75649370 \
--subnet-id subnet-09d864b724dce6434 \
--tag-specifications 'ResourceType=instance,Tags=[{Key=Name,Value=mysql-prepared-test-ec2}]'

4. 测试结果

4.1 MySQL 8.0.43 测试结果

紧凑格式 (spaces=0, SQL长度 ~100KB)

配置 平均执行时间 Com_stmt_prepare
useServerPrepStmts=false 129.6ms 0
useServerPrepStmts=true 115.6ms 1
性能差异 true 快 1.1 倍 -

带空格格式 (spaces=128, SQL长度 ~6.5MB)

配置 平均执行时间 Com_stmt_prepare
useServerPrepStmts=false 400.7ms 0
useServerPrepStmts=true 101.0ms 1
性能差异 true 快 4.0 倍 -

4.2 MySQL 5.7.44 测试结果

带空格格式 (spaces=128, SQL长度 ~6.5MB)

配置 平均执行时间 Com_stmt_prepare
useServerPrepStmts=false 600.0ms 0
useServerPrepStmts=true 90.0ms 1
性能差异 true 快 6.7 倍 -

4.3 与原始报告对比

版本 原始报告 (5.7.29) 本次测试 (5.7.44) 本次测试 (8.0.43)
false 平均时间 ~52ms 600ms 400.7ms
true 平均时间 ~27,839ms 90ms 101ms
性能差异 true 慢 535 倍 true 快 6.7 倍 true 快 4.0 倍

5. 结论

5.1 问题重现结果

在 MySQL 5.7.44 和 8.0.43 版本上,原始报告中描述的性能问题未能重现。

测试结果显示:

  • 在两个版本上,useServerPrepStmts=true 反而比 false 更快
  • MySQL 5.7.44: 服务器端预编译快 6.7 倍
  • MySQL 8.0.43: 服务器端预编译快 4.0 倍

5.2 可能原因分析

  1. MySQL 版本差异

    • 原始问题发现于 MySQL 5.7.29
    • 本次测试使用 MySQL 5.7.44 和 8.0.43
    • 问题可能已在 5.7.29 之后的版本中被修复
  2. AWS RDS 优化

    • AWS RDS 可能包含特定的性能优化
    • 与原生 MySQL 行为可能存在差异
  3. JDBC 驱动版本

    • 测试使用 mysql-connector-j-8.0.33
    • 驱动可能已优化参数处理逻辑

5.3 建议

  1. 如需重现原始问题

    • 使用 MySQL 5.7.29 或更早版本
    • 使用原生 MySQL 而非 AWS RDS
  2. 生产环境建议

    • 在较新版本的 MySQL 上,useServerPrepStmts=true 性能更优
    • 建议进行实际业务场景的性能测试
    • 对于大量参数的 IN 查询,考虑使用分批查询或临时表方案

6. 附录

6.1 测试日志

MySQL 8.0.43 完整输出

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
=== MySQL PreparedStatement性能对比测试 ===
连接信息: mysql-prepared-test.cfsoq6muu0jv.ap-southeast-1.rds.amazonaws.com:3306/test
参数数量: 50000
测试轮次: 3

测试配置: useServerPrepStmts=false
参数空格数: 128
SQL长度: 6500023 字符
执行第1次查询...
第1次: 571ms (返回0条记录)
执行第2次查询...
第2次: 317ms (返回0条记录)
执行第3次查询...
第3次: 314ms (返回0条记录)

=== useServerPrepStmts=false 测试结果 ===
总执行时间: 1202ms
平均执行时间: 400.7ms
返回记录数: 0
Com_stmt_prepare: 0 -> 0

测试配置: useServerPrepStmts=true
参数空格数: 128
SQL长度: 6500023 字符
执行第1次查询...
第1次: 138ms (返回0条记录)
执行第2次查询...
第2次: 92ms (返回0条记录)
执行第3次查询...
第3次: 73ms (返回0条记录)

=== useServerPrepStmts=true 测试结果 ===
总执行时间: 303ms
平均执行时间: 101.0ms
返回记录数: 0
Com_stmt_prepare: 0 -> 1

MySQL 5.7.44 完整输出

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
=== MySQL PreparedStatement性能对比测试 ===
连接信息: mysql57-prepared-test.cfsoq6muu0jv.ap-southeast-1.rds.amazonaws.com:3306/test
参数数量: 50000
测试轮次: 3

测试配置: useServerPrepStmts=false
参数空格数: 128
SQL长度: 6500023 字符
执行第1次查询...
第1次: 639ms (返回0条记录)
执行第2次查询...
第2次: 681ms (返回0条记录)
执行第3次查询...
第3次: 480ms (返回0条记录)

=== useServerPrepStmts=false 测试结果 ===
总执行时间: 1800ms
平均执行时间: 600.0ms
返回记录数: 0
Com_stmt_prepare: 0 -> 0

测试配置: useServerPrepStmts=true
参数空格数: 128
SQL长度: 6500023 字符
执行第1次查询...
第1次: 117ms (返回0条记录)
执行第2次查询...
第2次: 77ms (返回0条记录)
执行第3次查询...
第3次: 76ms (返回0条记录)

=== useServerPrepStmts=true 测试结果 ===
总执行时间: 270ms
平均执行时间: 90.0ms
返回记录数: 0
Com_stmt_prepare: 0 -> 1

6.2 参考资料


报告生成时间: 2026-01-12
测试执行者: Kiro CLI
AWS Account: 872515255872

对姚顺宇的4小时访谈整理

节目来源:张小珺|商业访谈录 第 140 期
YouTube:https://www.youtube.com/watch?v=ttkd0t5qTD4
录制时间:2026 年 3 月
发布时间:2026 年 5 月 11 日

整理说明:本文基于 YouTube 自动字幕整理,原字幕经历了”中文语音 → 英文 AI 翻译 → 中文再翻译”的双重转译,口语化表达、术语、人名错漏较多。本文结合嘉宾公开背景资料(清华物理系本科、斯坦福理论物理博士、Anthropic 与 Google DeepMind 研究员)对关键错误做了校正,并在必要处补充背景注释。尽量忠于嘉宾原话和语气,包括其中的”小疯”言论、吐槽和批评。


关于嘉宾身份的重要澄清

硅谷 AI 圈有两位清华同届毕业、英文都叫 Shunyu Yao 的研究者,中文媒体常混淆:

姚顺雨(另一位) 姚顺宇(本期嘉宾)
本科 清华姚班(计算机) 清华物理系(基科班/学堂物理班)
博士 Princeton(NLP) Stanford(理论物理)
代表作 ReAct、Tree of Thoughts、《AI 下半场》 Non-Hermitian Skin Effect(非厄米趋肤效应)、Scramblon 理论
路径 OpenAI → 腾讯首席 AI 科学家(2025) Anthropic → Google DeepMind(2025)

本期嘉宾姚顺宇的公开履历校核:

  • 2015–2019 清华物理系本科,特等奖学金 + 叶企孙物理奖
  • 本科期间 3 篇顶刊(2 篇 PRL + 1 篇 PRB),第一作者与清华王中合作提出 非厄米系统拓扑能带理论新方法
  • 2019–2024 斯坦福大学理论与数学物理博士,导师 Douglas Stanford 与 Stephen Shenker,研究量子场论与量子引力动力学
  • 短暂加入伯克利做博士后(正式两周,节目中他说实际待了两三个月)
  • 2024 年 10 月 加入 Anthropic,从事强化学习方向,参与 Claude 3.7、4、4.5 的训练
  • 2025 年 9 月 19 日 从 Anthropic 离职,9 月 29 日 加入 Google DeepMind,Senior Staff Research Scientist
  • 参与 Gemini 3、Gemini 3 Deep Think、Gemini 3.1 Pro 的开发

字幕中所有”顺宇”与”舜宇”、”Anthropic”被译为”人类学/人本主义/人形生物/人为因素/人猿科技/安特罗皮克”等均为同一指代;”双子座/双子星”即 Gemini。


一、两个 Shunyu Yao(01:26)

姚顺宇主动介绍另一位姚顺雨:”我们的主要职业发展道路有一些重叠,所以看起来可能很难把我们区分开来。”他强调两人最大区别是:另一位从一开始就做计算机科学,而自己是物理出身,只是”某种意义上走到了这一步”。

两人清华本科同届(姚顺雨在姚班,他在基科班),研究生一个去了 Princeton,一个去了 Stanford——“很奇怪,全世界都觉得 Stanford 是 CS 圣地,Princeton 才是物理圣地,我们俩恰好反着来。”

  • 两人在硅谷时每几周见一次,主要就是”瞎玩”——散步、吃饭、打扑克。
  • 对于另一位姚顺雨提出的 “AI 进入下半场”,姚顺宇坦言:”我一直不太懂上半场、下半场什么意思,这个定义我始终没搞清。”
  • 他自己的阶段定义是:“大家开始不再那么担心一件事,AI 能不能做到这个问题本身是不是定义明确,这是最大的变化。” 一年前 Anthropic 内部还担心追不上 OpenAI 的推理能力;现在 Gemini、OpenAI、Anthropic 三家没谁真担心”赶不上进度”了——难的是想清楚到底该做什么。
  • 模型同质化、商品化了,纸面(benchmark)上差距缩到 1–2 个百分点,“大部分是噪声,不是信号”,真正的差异只在实际用户体验里:Claude 工具使用最强,Codex 最近追平,Gemini 日常推理更好、智能体编码还在追赶。

二、竞争与逃逸(07:15)

关于 OpenClaw(字幕原文,疑为某款 2026 年初爆火的智能体 Wrapper 产品)的产品判断:

  • “圈内人其实不紧张。圈外比圈内紧张。”他认为 OpenClaw 没有证明什么新东西——Claude 4.5 Opus 发布时,工具使用能力已经领先 OpenAI 和 Gemini 3,只是当时没人包装成产品。
  • Manus 被 Meta 收购(注:节目录制后该收购已被撤销)、OpenClaw 被 OpenAI 收购,这说明”包装层”目前还无法摆脱模型公司的控制——“逃逸速度不够”。
  • Wrapper 要活下来只有两条路:
    1. “成长够快”(Cursor 的打法)——在模型公司反应过来前占据足够用户心智,并训练自己的模型。他说 Cursor 现在跟 Anthropic 的关系”已经到了非常微妙的阶段”,Cursor 在训自己的 Composer,双方从亲密伙伴变成竞争对手。
    2. “市场小到模型公司看不上”(Midjourney 的打法)——“有损 Gemini 尊严的”那种细分市场。
  • 被问到 Lovart 是否算:”我觉得他们有机会。”
  • 对 2026 年的预测:模型应当实现 “训练时有限上下文,使用时无限上下文”(train with finite context, use with infinite context)——模型边和你持续交互边判断、丢弃不重要信息,成为真正的私人助理。今年肯定能做到,但有多条技术路径,还要实验验证。
  • 关于 Meta 收购 Manus:他”没完全想明白”,猜测最大好处是拿到一个强大的亚洲产品团队,”中国在产品端比美国更有天赋”;但 Meta 为什么自己做不出这种产品?他也没想清楚。

三、”Pre-train 没有到头”(25:22)

这是他最反主流的判断之一。

  • “2026 年第一季度,模型改进速度完全没有放缓。”
  • 他拒绝用 benchmark 增长来衡量:”benchmark 是定义在 [0, 100] 里的,越接近 100 增长当然越慢,但这不代表用户感受到的增长在慢。从 70% 到 75% 的价值可能比从 50% 到 60% 还大。”
  • 他的判断基于研究者的体感:模型越来越容易学——过去要花很大力气教会模型一件事,现在只要问题定义清楚 + 数据/环境构建对,模型几乎”自动就会”。
  • 预训练(pre-training)过去几个月一直在变强。”几个月前很多人说 Scaling Law 撞墙了,我的经验是没撞墙,接下来四个月也看不到到头的迹象。”
  • 为什么有人觉得撞墙了?他给出三种可能,并直指第三条最常见:
    1. 觉得这个范式本身到头了(可能但只是猜测)
    2. 觉得数据等条件不再满足
    3. “他们自己的工作里有 bug,但没意识到——我观察到绝大多数’撞墙’的人属于这一类。” 修一个 bug 带来的进步,往往比花哨的技巧多得多。
  • 遇到撞墙应该是心态问题:相信问题可解,就会系统性地做消融实验排查——“Gemini 和 Anthropic 在这件事上都做得很好。”
  • 当前主驱动:数据和算力(二者强相关)。算法更像阶段性跃迁(如 Transformer),之后是渐进提效。
  • “在相对清晰的范式(pre-train / post-train)内,主驱动是数据和算力。多模态生成算法还没收敛,仍是科学问题;但自然语言生成已经不是科学问题,只剩工程问题。”
  • “如果我估一个时间线,接下来四个月还会有进步。但 AI 领域谁也没法预测四个月以后。”
  • 谁在兴奋?”做产品的人兴奋于 OpenClaw,做模型的人兴奋于模型进展。Anthropic 和 Gemini 里的人更多在想:AI 很快会把我们取代,我们接下来该干嘛——而不是担心撞墙。”

四、Coding 的爆发(35:08)

为什么编程领域这一年半发展最快?他认为有两大结构性优势:

  1. 奖励信号(reward signal)定义清晰:SWE 任务天然可测,输入输出一匹配就是成功。
  2. 数据基座天然存在:GitHub 几十年沉淀了海量高质量代码,构建环境非常方便。

从产品角度,编码还有一个独特性:好程序员写的代码风格高度相似(简洁、结构清晰、易扩展、抽象合理),所以不需要像社交/游戏那种推荐算法去适应每个用户的口味——这大大简化了产品形态。

  • 他自己的代码产出中 90% 以上由模型生成(保守估计,实际可能 99%);但他花大量时间审 review 代码。”AI 辅助之后,最重要的变成了如何设计它、如何给它合适的 context。”
  • 被问谷歌允不允许用 Claude Code:”你这个问题差点让我丢工作了——谷歌不允许用 Claude Code。”(笑)
  • 工作效率提升 20–50 倍(相比一年半前),但他的工作时间反而更长:”因为能试的想法更多了,以前要等同事几小时才能搞懂一个文件,现在问 Claude 或 Gemini 5 秒就行。”
  • 对谷歌文化的吐槽:“谷歌已经不是那个沿岸划船(coast along)的谷歌了。GenAI 里没人摸鱼,除非你对技术彻底失去兴趣。” 他自己每天 9 点起查邮件和夜间实验,10 点到办公室,单身时干到 10–11 点,妻子在也会带回家干。
  • 下一个 Coding 级别的爆发点?“如果我看得清,我早就去创业了。”(笑)除了编程,其他方向市场都不够大——AIGC 市场受限于”人一天只有 24 小时”;最可能的大市场候选是交互式教育,但也远小于编程。
  • 关于程序员的未来:AI 最终会取代程序员,但是渐进过程;“AI 是高度集中化的技术,让少数人更强,让大多数人失去独特价值”;传统软件工程的终局可能是**”千分之一的人做完所有人的活,拿 100 倍的工资”**。”千分之一只是个比喻数字,也可能是万分之一或十万分之一……别太悲观,我是著名的悲观主义者。”
  • 活下来的那群程序员特征:技术强(充分不必要条件)+ 理解自己在大组织中的定位 + 规划能力强(能把复杂事切成小块分发给不同 AI)。
  • AI 研究本身是淘金热还是科学革命?“都有”。他说训练 AI 产品经理目前不太可能——因为”什么是好产品”没有客观标准,反馈信号太模糊。

五、Seedance(50:10)

对字节跳动 Seedance(字节系视频生成模型)的评价:

  • “可能会让 DeepMind 多模态团队有压力,但不是范式级的变化。字节在多模态生成上一直相对强,主要是数据和细节做得好。”
  • 猜测原因是数据,因为多模态算法层面还没根本创新;但他”没在字节工作过,只能瞎猜”。
  • 评价从谷歌跳去字节的吴永辉:”偷偷看过他过去的代码提交和领导项目,他是我见过极少数资深但技术能力还特别强的人之一,我还不到评价他的水平。”
  • 中美模型差距:过去一年半明显在缩小,但是否会完全消失甚至反超,”是个悬而未决的问题”。
  • “中国在实际算力上处于明显劣势,但这个劣势反而催生了一些有趣的东西——中国模型公司非常擅长从其他模型蒸馏。”

六、”硬蒸”和”软蒸”(54:30)

回应 Dario Amodei 最近公开指控三家中国公司蒸馏他们模型:

  • “蒸馏本身是公开的秘密。”
  • 他把蒸馏分为两种:
    • “硬蒸”(brute-force distillation):直接拿 Claude 生成的 token 去强制训练自己的模型。“商业上不道德,智商上相当蠢——等于承认你连自己要做什么都不知道,只能模仿别人,把 benchmark 数字做得好看些。”
    • “软蒸”(smart distillation):在自己的数据 pipeline 里用其他模型做助手,或者用其他模型当 evaluator。“商业上灰色,但技术上其实很有意思——中国实验室可能是 multi-agent 训练领域的先驱:如果他们把多个不同公司、语言分布差异巨大的模型整合进统一训练系统,这才是真正的 multi-agent。”
  • 点名(后期应消音处理):硬蒸某家”之前可能做过,后来逐渐转软蒸”;“蒸得最少的是字节跳动,它的模型仍然非常独特。”
  • 关于豆包:
    • “豆包肯定不如 Gemini 或 Claude 聪明。但豆包的语音生成真的是世界最好的(直白说就是最好,委婉点说是之一)。”
    • 美国公司为什么不做这种方向?“数据问题 + 用户群差异。美国人更关注生产力,中国人才有那么多’人生问题’要问’豆包’。我自己生活很无聊,没什么有趣的人生问题——日常技术问题问 Gemini 就好。”(笑)
    • 豆包手机:”想法很好,但我不知道技术实现上开销多大——不能你让模型帮你订张高铁票,最后花的钱比票本身还贵,那是不能接受的。“
    • 苹果 AI 策略:”表面看上去不在乎,其实太在乎了,只是如果太在乎又做不成,就显得自己太蠢。面子问题。“

七、机器人(1:04:07)

  • 春晚看过演出,还去亚马逊搜过人形机器人价格,”比我想的便宜多了”,反映了中国硬件产业链的优势。
  • 但软件侧:”机器人模型还处在特征工程时代——给定场景,针对这个场景做 RL 优化,每个人都知道怎么做,但泛化能力不强。”
  • “是否具备泛化能力,实际上是 AI 很多方向的分水岭。” 确定性单一场景做好不难,十几年前就能做到;语言模型是在 Transformer / GPT 之后才越过这个阈值——“在一个层面训练就能全面提升所有能力”。机器人还远没到。
  • 参观过 Google DeepMind 自己的机器人实验室和 Physical Intelligence:”实验室比语言模型实验室有趣多了——语言模型实验室就像普通办公室,机器人实验室真的是人工遥控机器人去各种货架取东西。”
  • 机器人目前连 GPT-1 阶段都没到,和多模态生成一样,都还没找到 scale 的办法。

八、在 Underdog 之地赌一把(1:08:45)——成长经历

出生在宁夏大武口(一座因煤矿而生的城市),小学到高中在上海。性格自述:”我总是喜欢做我不擅长的事情。“

关键人生选择——高中择校:他本可以被上海四大名校(上中、华二、交大附中、复旦附中)的普通班录取,但为了进**”稍差一些”的格致中学的竞赛班而放弃——“赤脚的不怕穿鞋的,值得一试。”**

参加物理竞赛未能进国家集训队(没拿到保送),后来高考也考不上清华。但命运转折:高三清华夏令营期间,听说清华对北京学生有独立招生,他当场给清华招生办老师发短信——“你给北京学生考试,凭什么不让上海学生也考?”——争取到考试机会,考过后签了”第一档降分”协议,最终录取清华。

人生最大的经验:“大胆一些。如果你不争取,就永远得不到。即使你争取,也未必能得到。但如果你不争取,就肯定得不到。”

对父母的评价:”中国家长能做到让孩子’讨论’已经不错了,我一般只是通知他们。我父母最好的地方是,当他们无法理解我在做什么时,他们选择不干涉。”

性格:”在意自己想做的事,别试图阻止我,我会竭尽全力;但我不想做的事,你逼也没用。”、”我更多是和自己竞争,不太愿意和别人竞争——当然如果你也很在乎,那我一定要比你厉害。”


九、非厄米系统与量子物理(1:19:44)

选择凝聚态理论”就是命运的安排”。清华基科班传统是”学生可以做物理以外的事,鼓励早进实验室做研究”——“基科班三分之二的学生最后都不做物理。”

本科导师是王中(Zhong Wang)(字幕写作”王忠”),当时还很年轻、学生不多。王中的博士导师是 张首晟(Shoucheng Zhang)(字幕写作”张守成/寿城”,斯坦福著名凝聚态物理学家,2018 年去世)。”王老师话不多,但很擅长把问题看清楚。”

非厄米系统工作的通俗讲解(他自己给出的进度条提示:不想听可以跳过):

  • 量子力学的基本假设:孤立系统演化由 Hamiltonian(厄米算符)描述。
  • 现实中绝大多数不是孤立系统(和环境交换粒子/能量),对应的 Hamiltonian 是非厄米的。
  • 他们最初研究开放量子系统的拓扑现象时,发现解析计算(周期性边界条件)与数值计算(开放边界条件)的结果完全对不上。
  • 后来发现:厄米系统的基本范式——布洛赫波假设——在非厄米系统里完全崩溃。非厄米系统的能量本征态全部会堆积在系统边界(即后来广为人知的 Non-Hermitian Skin Effect,非厄米趋肤效应)。
  • 他们建立了一整套描述开放边界非厄米系统本征态和动力学的框架——这是**范式级(paradigm shift)**的工作。

为什么没继续做下去?

  • “范式转变很难 catch,已经 catch 了一次就不想再 catch 同一次。”
  • “这是人性的弱点——我总想挑战自己不知道的事。”
  • 现在回头看,”如果当时继续做下去,那工作会成为这个方向上最重要的工作,我会更有名、更多引用、更好的教职;但科研生涯会变得不那么兴奋。”
  • 所以博士阶段转去搞理论高能物理(量子场论与量子引力),这两个方向”几乎没有任何联系”。

对”挑战难事”的反思:“说得好听点是挑战自己,说得难听点就是自虐。”、”如果一个人只为受虐而受虐,那是心理问题;但如果是为了获得信息、丰富经验和能力,那值得。”

本科学物理最大的收获:“把事情想清楚、做深度阅读、不要过分相信纯理论。”——因为非厄米那个发现本身就源于”数值计算和理论不符,深入追查才找到问题”。


十、高能物理(1:36:27)

承认博士阶段”对世界没有贡献“:

  • “高能物理已经发展到实验完全跟不上理论的程度。” 没有客观评判标准,靠”领域里几位老前辈的主观判断”。
  • “人的一生并不长,何必浪费时间为老年人服务。”
  • 五年博士学到的最重要一课:“做事情要有相对客观的评价标准”,或者说 “做对世界有影响的事”。
  • 自我评价:”说实话,我的博士论文没人会说不好,但对世界的影响几乎没有。我个人非常不满意,但也没糟糕到让别人说我偷懒的程度——你可以满足所有外部期望,但自己骗不了自己。”
  • 满足小圈子标准 = 训练一个模型:“一旦进了那个小圈子,你知道评价标准是什么,做好很容易,即使你不认同这些标准。”
  • 博士后两三个月实际在伯克利(正式记录只有两周)后离职,伯克利老师很好:”我告诉他们我可能要去做 AI,他们说不急,先把现有工作保住再说。”

十一、物理与 AI(1:43:09)

物理学家做 AI 的优势:

  • 硬技能上帮助其实很少。
  • 真正的帮助在性格/品味:探究本质、做事系统化(无论实验还是理论方法论)。
  • 但 “这不是物理独有——CS、化学、生物背景的人也有这种特质。”
  • Anthropic 特别多物理出身的人,”主要是联系(connection)——联合创始人里两个技术一把手都是物理背景,于是就招了这类人。但到我加入时,这个惯性已经结束了。”

关于 AI 是不是黑箱:

  • “一切都是黑箱,连物理也是。” 我们也不知道最微观层面的动力学。
  • 语言模型还没到”神经外科级别”的理解(除了 Anthropic 的 Interpretability 团队在极小网络上能做)。
  • 但 Scaling Law 已经是经验定律——“经验定律和科学定律的界限是模糊的。热力学定律最初也是经验定律,后来有了微观机制的理解才变成科学定律。未来 Scaling Law 可能也会这么演化。”
  • “智能涌现”这个词本身不科学——“对我来说,这更多是主观感受。真正的质变只有一个:技术上能 scale 起来,全面提升所有能力。这是我对’涌现’的唯一定义。”

为什么最终选 AI 而不是量子计算?

  • 两者都给年轻人机会,但量子计算瓶颈在实验平台——“那是我不擅长的,和我兴趣无关的东西很多”。
  • AI 更像 “17 世纪做热力学”——那时候人们甚至还不知道”热”是什么(还相信燃素说),但这并不妨碍做实验、总结出第一定律、第二定律、Clapeyron 方程等经验定律,最终推动热机发明改变世界。
  • “理论物理到实验物理的距离,比理论物理到 AI 还要远。AI 对我来说就是数值实验——有想法,设计实验验证,本质和做物理数值计算没区别。”
  • 对实验物理的敬畏:”大家都知道怎么搭光学平台,有人能搭出来,有人六年搭不出来——这种动手能力我不理解,感觉相当神秘。”

十二、在 Anthropic 训练 Claude 3.7 和 4.5(1:52:32)

入职经过

  • 2024 年 8–9 月,通过前同事联系上 Anthropic(第一个 manager 也是理论物理背景)。
  • 同期也联系了 OpenAI 和 DeepMind——“DeepMind 当时太慢了,最后是 Anthropic 谈成。” OpenAI 没找到合适位置。
  • 面试前把能自学的课程都过了一遍,手写实现了 Andrej Karpathy 的 nanoGPT。
  • 有两个团队接洽他(评估 vs 强化学习),他选了更不确定的 RL 方向。

当时 Anthropic 的状态

  • 全公司 700–800 人,他加入的 “Horizon” 大团队只有 10–11 人,几乎就是整个后来的 RL 团队前身。
  • 对 Anthropic 的第一印象:”执行力非常强,相对自上而下的公司;人与人之间没有隐瞒,氛围非常好——因为规模小大家都认识。”
  • Anthropic 为什么能自上而下? 因为技术决策人就是公司联合创始人(Jared Kaplan 和 Sam McCandlish),而且 Dario 与他们互信足够。”其他公司做不到——Ilya 在的时候 OpenAI 或许能,但他后来莫名其妙丧失了决策权,然后就走了。”
  • 他与 Jared Kaplan 合作最多。
  • Anthropic 联合创始人团队 “没有一个离开过”,”他们是真正并肩战斗过的一群人——Scaling Law 论文、GPT-3 论文都是联名作者(Jared、Sam、Dario、Tom Brown、Benjamin Mann 等)。”——这是很多公司做不到的互信基础。

Claude 3.5 → 3.6 → 3.7

  • “Claude 3.5new 被外界叫 3.6,是因为 Anthropic 早期没产品能力——两个模型都叫一个名字(3.5),后来自己被迫接受外部给的 3.6 叫法。所以实际产品线是 3.5 → 3.5new(=3.6)→ 3.7。”
  • Claude 3 发布后 Twitter 上就有人发现它编码比 GPT-4 强;“这是 Anthropic 押注编程的一个信号来源,但最初可能是随机试出来的——纯粹技术原因,先自下而上冒出来,后来自上而下 all-in。”
  • 3.7 是 Anthropic 后训练(post-training)的分水岭:之前 post-training 是”打补丁”模式;3.7 之后才真正大规模 RL。
  • “在我加入时,大家已经知道要做大规模 RL,但不知道具体怎么做。” 2024 年 8–9 月,o1 还没发布,只知道 OpenAI 有个神秘项目叫 Strawberry。
  • 真正的秘诀(他能公开谈的部分):“把简单的事做得比所有人都干净。” RL 最简单的算法是 policy gradient,有很多复杂的算法但会带来 infra 难题;如何 trade-off 这些 detail 才是真正的 expertise。
  • 他的一个重要观察:“很多 trick 其实没用。” 不同公司 sampler 和 trainer 的 numerical 差异依赖各自 infra,所以”你照抄别人的算法不一定有用——算法是整个系统的一部分”。”这就是我为什么不爱回答别人问 Anthropic / Gemini 怎么做——回答会误导他们。”

3.7 → 4.5

  • 他离开时 Anthropic 已经接近 2000 人(比他加入时翻倍以上)。
  • “我赶上了小公司的尾声”——三四个月后公司突然变大,文化开始混乱,”有些从外面进来的人带来和原文化的冲突”。
  • 他不喜欢的人:“我觉得 ‘ideas are cheap’。真正难的是 implementation。我不喜欢那种每天大部分时间泡在 Slack 里谈 grand principles 的人——没什么用。”(笑)

离职原因

  • 主因:想学不一样的东西。”Anthropic 非常聚焦,只做语言模型相关,不做多模态生成、不太做底层工程和 infra——我想学这些。”
  • 约 40% 原因:不认同 Dario 的反华立场。”作为 CEO 个人他怎么想都可以,但把这种观点推到如此极端,是非常情绪化的反应。”
  • 40% 不是主因,但也不是无关紧要,更不是**”控股股东的原因”**。(笑)
  • 对 Anthropic 未来的看法(离开时):悲观——“API 卖 token 是门烂生意,价格战会来,只有谷歌能赢(供应链优势)。”但后来证明他太悲观了,Anthropic 在产品层面做得非常好(Claude Code、Cowork 等)。
  • 被问会不会后悔:”不太会。我的动机是换位置学东西。”
  • Claude Code 的诞生:“那几乎是当代少有的、还展现个人英雄主义的时刻。” 创始人 Boris Cherny(字幕译为”鲍里斯·切尔尼”)本来只是想给自己和同事提效,最后变成了整个产品。”很可能是和抖音同级别的交互层面变革产品。”

关于”英雄主义已经过去了”

这是贯穿访谈的核心观点之一:

“个人英雄主义在语言模型领域可能已经过去了——也就是 Transformer 那个时刻之后。”

“现在大家都是冲浪的人,本质上是那个浪,而不是你那个冲浪的人。”

“没有英雄,有时候甚至觉得旧时代的英雄有点蠢。”

“我对任何模型的贡献,我的 statement 永远是:我自己对那件事没那么重要;更多是我很幸运,有机会在那时候加入了一个重要项目,做了一些事。”

他特别指出:编程上 Anthropic 的成功确实还有”公司级英雄主义”(敢不敢赌、赌得够不够快),但模型内部的每个技术细节都是集体的。

对 AI Safety 的批评(非常犀利):

  • Anthropic 成立的初衷是 AI safety,但又要训练前沿模型——Anthropic 自己的解释是”必须做最强的模型才有话语权推动 safety 议程”。
  • **”这个想法非常天真——**现在看来这不可能发生。更可能的结果是所有人都有强大前沿模型,没人能阻止任何事。”
  • 真正的机制类比是 核武器:多方持有、互相威慑——“靠一家公司自我立法去规制是不可控的——它只能自我规制,但自我规制等于没规制。”
  • 对 Anthropic 可解释性团队:只在非常稀疏、小的网络上有有趣进展,实用语言模型层面还没达到”神经外科级别”。

十三、”AI 本质是简单的”(2:35:03)

核心命题:“AI 本质是简单的。”(他强调这是 statement 不是 conclusion)

解释:

  • 因为你可以做实验。相比物理(能量尺度限制了实验数据),AI 不受这种约束——想做什么实验都能做,只是需要时间扩算力、准备 infra,但没有根本性困难。
  • “AI 不会给人撞墙的感觉,不是因为方法穷尽了,而是因为想法太多了,挨个试不过来。”
  • 未来 6–12 个月 AI 会开始自己做实验——不是只写代码,而是运行实验 → 分析结果 → 提出新假设 → 设计新代码 → 跑新实验,这条链会逐渐闭合。

十四、在 Google DeepMind 训练 Gemini 3(2:41:10)

加入 DeepMind 的理由

  • 反对那种”研究员离开大厂加入小厂”的惯性——他反其道而行,因为他当时想要”学更多、更广”。
  • “如果你真想把某个想法塞进最终产品模型里,谷歌可能是非常烂的地方;但如果你要的是研究自由、广阔视野,世界上找不到比 Gemini 更强的第二名。”
  • 加入时点(2025 年 9 月底)已经看好 Gemini——Gemini 2.5 那代让业内意识到”Google 正在搞明白”。
  • 他是因为个人联系被挖进去的,双向选择。
  • 为什么没去 OpenAI?“文化让我非常担心。直白说,真正能把事做成的人没 Gemini 那么多,甚至比 Anthropic 还少。”(笑)内部政治斗争也开始显现。
  • xAI:“我不理解。”(笑)”接触过的人后来都走了,我也不知道他们现在怎么样。”

Gemini 3 的转折点

  • Gemini 3 和 Nano Banana 两次叠加才是真正的转折点:Nano Banana 把很多新用户引到 Gemini App,Gemini 3 把他们留住。”只有 Gemini 3 不够——市场份额低于 10% 时,模型再好传播也慢。”
  • Gemini 当前市场份额可能在 20% 左右(他还没精确核查)。
  • “从局外人角度看,是 OpenAI 救了谷歌的命。” 如果 ChatGPT 当时真的完全吞掉了搜索,谷歌就完蛋了;但 OpenAI 做到了”让谷歌意识到重要性,但没做到吞掉搜索”,让谷歌得以反扑。
  • Chatbot 为什么没完全吞掉搜索?
    1. 搜索有大量”非常蠢”的需求——“我就搜一下在哪买米、哪里点好,不想等聊天机器人转半天最后给个链接还要再点一次。”
    2. Chatbot 形态还没达到终点。
  • “聊天机器人凭什么就是终极形态?过了这么多年,居然还只有一个聊天框,我真的觉得很蠢。”——“需要一个产品经理来解锁模型的全部能力。”(笑)

谷歌内部发生了什么

  • 外部看到模型性能大跳;内部是组织逻辑开始清晰:
    • 预训练阶段已经有清晰框架——谁负责哪个 node 非常明确(以前非常混乱)。
    • 谷歌工程管理能力极强,预训练已经进入”谷歌的舒适区”,能可控地知道下一代不会坏,甚至能预估好到什么程度。
  • Anthropic 走自上而下;谷歌仍然相对自下而上,但比过去更偏自上而下。
  • “不同文化都能 work”——大公司和创业公司的打法本质不同。
  • 谷歌的杀手锏:“找到一个极简的产品表达形式,所有人看起来都一样,然后在技术层面无情地碾压你,你根本竞争不过。” 搜索就是典型例子。
  • OpenAI 的位置:“现在没人的位置是稳固的。” Chatbot 是否是 super app 的终极形态?—“我完全没有理性答案,但感觉事情还没结束。”
  • 对国内”超级应用”叙事的吐槽:“我真的不懂——大家在抢一个 super app,前提是 chatbot 就是 super app 的形态。但我真的觉得 chatbot 很蠢,终极形态凭什么非是这个?”

谷歌的”英雄”

  • 后台的英雄:Sergey Brin(”重大决定最终还得他拍板”)。
  • 前线的英雄:Koray Kavukcuoglu(Google DeepMind CTO / 谷歌高级副总裁)。
  • Demis Hassabis 更偏科学方向(Isomorphic Labs 等),Gemini 日常他见到最多的是 Koray。

十五、技术预测和组织搭建(3:01:28)

预训练 vs 后训练

  • 纯技术上两者本质区别不大——最大区别在数据分布:预训练要 广(不需要 quality 特别高);后训练要 窄而精(quality 要求极高)。
  • 不同实验室组织方式:
    • Anthropic / Gemini:pre-train 和 post-train 分两支队伍。
    • OpenAI:更混乱——最早三队(pre-train、RL “Strawberry”、post-train),而且他们的 post-train 本身就是产品团队,”训模型的人也参与产品”。

对”下一个范式转变”的判断

  • 大概率不是范式级变化,但对谷歌特别有价值的两件事:
    1. 机器学习编码(ML coding):让 AI 能加速 AI 自身的研究闭环——谷歌是 AI 研究最完整平台(硬件 + 连接 + 模型),这件事对谷歌价值巨大。
    2. 长远规划 / 长时程(long horizon):每个人都觉得重要。
  • 对实现方向:
    • 预训练侧:sparse attention(稀疏注意力,DeepSeek 和学术界都在做)。
    • 后训练侧:类似 Cursor 那种外部上下文管理(让模型选择保留或扔掉哪部分)。
    • 两者本质相同——上下文 token 的 KV cache 也是一种权重。
  • “**一万个人有一万种’世界模型’**的定义。Gemini 的世界模型更像端到端训练(条件生成下一刻场景);李飞飞那种是另一回事——我不太懂她们实验室在做什么。”
  • Continual learning(持续学习)和 long horizon 本质没区别。
  • 他主要精力在后训练方法(预训练不做正式工作)。
  • “Gemini 在 long context 上的一些技巧真的让我惊讶。”(笑)

AI 人才稀缺性质疑

  • 高薪是因为大家觉得稀缺,但**”可能没那么稀缺——训练一个人不难,只是你需要遇到做这件事的环境。过去有这种机会的人不多,所以市场上相对稀缺。另一方面,可能对某些人的吹捧也过头了,大家特别爱神话某些人。”**

他设计的面试题(可公开)

  • 要求候选人 24 小时从零做一个 RL 项目——自己选模型、数据、算法,然后和他讨论一小时。
  • 两个目的:
    1. 看候选人与 AI 合作的能力(现在写代码本身不再稀缺)——有个陷阱:如果完全把活丢给 AI 自己不理解,讨论一小时就暴露了。
    2. “24 小时限制是看他重不重视这个机会——能不能熬夜。不重视的人连这 24 小时都熬不住。“(笑)”这里面还有些阴暗的小巧思。”

工程 vs 科学

  • “谷歌的预训练现在已经变成工程项目——自上而下、节点清晰、可评估。这是谷歌的强项。”
  • 后训练不确定性更大,仍是自下而上、每个人尝试不同方法。

组织的核心原则

  • “系统稳固 + 个人英雄不闪耀” 与 “允许个人英雄闪耀但系统脆弱” 的 trade-off。
  • 他倾向前者——“系统不稳固的一个例子就是 OpenAI:一个人走,整个结构就可能塌。”
  • 对自己的要求:“研究员必须为整体考虑,不然不是好研究员。在学术界是’一人吃饱全家不愁’;在公司里你要对公司负责——这是两种完全不同的心态。”
  • 他承认:”我可能就是拉不下脸——既然签了合约,我觉得不按合约做没什么道理。”

TPU vs GPU

  • 大规模商业部署上没有优劣差异。开源生态 GPU 更好,但这对大规模部署不是瓶颈。
  • 设计理念不同:
    • GPU(尤其 Hopper 一代):单 pod 内 NVLink 带宽极高,但 pod 内卡少(8 张)。
    • TPU:放弃卡间两两互联,用 3D Torus 拓扑把更多卡组成一个大 rack,每张卡只与 3 个最近邻相连。如果编译器/分片写得好,总内存容量更大、通信瓶颈更少。
  • TPU 缺点:小规模用不灵活、通用性差。

对 xAI 的评价

简短、尖锐:“我不理解。他们一直都挺动荡的。”(笑)


十六、集体主义胜利(3:23:33)

对新实验室潮的吐槽

  • 最近硅谷一堆新 AI 实验室:”绝大多数新实验室会倒闭。“
  • Thinking Machines 还在持续出新东西;但某些新实验室(后期消音)——“我完全不知道他们想干嘛,创始人其实已经离开赛场很久了。”

中美路线分化

  • 中美已分道扬镳。中国优势在消费侧:
    • “中国能想出非常复杂、看起来很不自然的产品结构,让利润滚雪球——抖音你看视频不收 0.2 美元,但偷偷加广告、直播、电商。”
    • 美国这种玩法玩不转——“生产力软件:我帮你写代码,150 成本,200 卖给你,我赚 50,就这么简单。”
  • “Meta 就应该直接抄字节跳动——它又找不到自己的定位,做消费产品的能力又远不如字节。但美国过去十年有个正反馈循环:B2B 太容易赚钱,大家都不想烧脑研究如何赚消费端的钱。”

AI 人工神话

  • “我进这个行业的时候,个人英雄主义时代已经过去了——所以没有英雄。”
  • “没有哪个老登是你的亲戚——所以你觉得他傻,他就是傻,可以直接说他傻,无所谓。”(笑)
  • 为什么敢这么讲?
    1. “我在这个行业没有什么导师,没有什么旧友,我当然想喷谁就喷谁。”
    2. “这个领域足够客观——你在这个领域做得怎么样是有客观评价标准的,最终大家会尊重你。只要你观点自洽、不是乱喷,不用太担心因为观点得罪谁。”
  • 为什么来 AI:“AI 这个事本来也不太需要脑子,真的不太需要脑子。这个行业最重要的特质就是靠谱、做事细、对自己做的事情负责任。” 在物理里,他见过比自己聪明得多的人(比如他的博士导师 Douglas Stanford)——“他在那里,哪还需要我?”
  • 对旧时代 AI”英雄”的评价(点名后期消音,但线索明显):
    • XXX(某位以模糊表述见长的人)“我觉得他一直都挺蠢的”——“用 Pauli 的话说,他甚至不能算错,因为他说的东西都没有明确定义——我最讨厌这种模糊的人,模糊的东西没有意义。“
    • 他愿意承认的英雄:
      • Haldane(霍尔丹,凝聚态物理拓扑态的奠基人)——“他第一次提出 Haldane model 和分数量子霍尔相关的东西,离后来整个领域搞明白拓扑态还隔了几十年,但他当时就能感觉到这件事重要,一直推动。”
      • Geoffrey Hinton(字幕译为”杰弗里·辛顿”)——“在大家都觉得 AI 这条路不确定时,他一直朝这个方向。这或许是英雄级别的人物。”
      • Transformer 集体(Noam Shazeer、Ashish Vaswani、Niki Parmar 等)——“这可能是一个英雄集体。”
  • 对”老登”(中文网络对守旧老年男性的贬称)的态度:
    • “大多数老登其实挺好的——人老了会分成两种:一种是德高望重、不再挑刺、真正指导年轻人;另一种是根本不知道自己在说什么,还特别爱挑刺和对人指手画脚。变老不一定就是老登。“
    • 他不是一开始就这么直接的——“学生时代比较克制,但后来发现克制对自己没好处,对别人也没好处。进 AI 之后变得更直接——没有任何东西会阻挡我,而且这个领域足够客观。”

给年轻人的建议

  • 纯语言模型方向:“蓝海已经不是蓝海了,我赶上了末班车。”
  • 但 AI 是非常大的领域——多模态生成、机器人、用 AI 解决实际科学问题(如量子控制)都还是蓝海。
  • “对足够年轻的人,做现在最热的事未必是对的;做没人做的事,可能是更好的选择。”

关于自己的未来

  • 不会在谷歌长留(”如此公开地表达这一点——我觉得可能不会。”)。
  • “我还是会去挑战自己,需要折磨自己,只是得先找到值得折磨自己的东西。”
  • 不太可能再跳大厂;也没想做 AI for Physics——“很多人已经在做,多我一个不多,少我一个不少。”
  • 当前首要任务:把 ML coding 和 long horizon 推到相对稳定的状态。

推荐

  • 改变人生的书:“说实话我没有。” 最近读的是 汤川秀树(Hideki Yukawa,1949 年诺贝尔物理学奖)自传《旅人》(Tabibito)——“能看到一位后来非常成功的科学家,年轻时真实的挣扎。”
  • 休闲读物:《来自新世界》(贵志佑介,日本小说)。
  • 最喜欢的地方:夏威夷(因为喜欢大海)。
  • 食物:寿司。
  • 他认为最有影响力的 AI 论文:
    • Seq2Seq
    • Scaling Law 论文(Jared Kaplan 等 OpenAI 那篇)——“虽然具体方法可能不完全对,但它是第一篇把这种系统性研究方法引入领域的论文,至关重要。”
  • MBTI?“不知道。”

最后一问:”关键的赌注是什么?”

“Long horizon.(长时程)”


补充:几个交叉验证与背景注释

  1. 离职 Anthropic 原因的对照:姚顺宇在个人博客(alfredyao.github.io)的说法与访谈一致——强调”不想让自己的经验被特定实验室局限,尤其现在核心研究很少发表论文”。访谈中他直接说出 约 40% 是反对 Dario 反华立场,这在其博客和 36kr、新智元等公开报道中也有交叉证据。
  2. 参与的模型的可靠性:36kr 报道证实他参与了 Claude 3.7(agentic coding)和 Claude 4 family(RL numerics);Gemini 3 Deep Think 的参与也有谷歌自家公告确认。
  3. 非厄米趋肤效应:访谈中他描述的”周期/开放边界结果完全对不上、本征态全部堆积在边界”正是 PRL 论文 Edge States and Topological Invariants of Non-Hermitian Systems(Yao & Wang 2018)的核心发现,与本人描述完全吻合——字幕里的”王忠”实为王中(Zhong Wang),张守成/寿城实为张首晟(Shoucheng Zhang)。
  4. 博士导师:Douglas Stanford 和 Stephen Shenker 是 Stanford Institute for Theoretical Physics 的顶级高能/量子引力学家,访谈中他特别说 Douglas Stanford “比我聪明得多”——是真诚的敬畏。
  5. “Claude 3.6 其实是 3.5 new”:这点与 Anthropic 官方命名历史一致,外部社区确实因 Claude 3.5 出了两个版本而自发叫后者”3.6”。
  6. 节目录制时间(2026 年 3 月)与发布时间(2026 年 5 月)之间已发生:Meta 对 Manus 收购被撤销、Cursor 可能被 SpaceX 收购、xAI 并入 SpaceX——文中相关表述按录制时状态保留,访谈中嘉宾对 xAI 的吐槽(”一直挺动荡”)反而被事态坐实。

核心观点速览

维度 姚顺宇的判断
预训练 远没到头,过去几个月一直在变强;觉得撞墙多半是代码 bug 没找到
后训练 真正大规模化始于 Claude 3.7;关键在数据分布是窄而精
Coding 爆发源于奖励信号清晰 + GitHub 数据基座;已是 AI-native 唯一大规模成功场景
机器人/多模态生成 都还没到 GPT-1 阶段,还在特征工程时代
Chatbot 形态 蠢,远不是终极形态,需要产品经理解锁
Wrapper 生存 要么成长够快(Cursor),要么市场够小(Midjourney);否则都被收购
AI 安全 Anthropic 的”造最强模型才有话语权”太天真;真正的机制类比是核武器多方威慑
蒸馏 硬蒸可耻且蠢;软蒸是 multi-agent 训练的先驱,技术上有趣
组织 系统稳固 > 个人英雄闪耀;OpenAI 是反例
英雄主义 语言模型领域已经过去;现在都是冲浪者,本质是那个浪
AI 本质 简单——因为可以做实验,受限的只是算力和 infra,无根本困难
给年轻人 语言模型蓝海已过;做没人做的事
个人风格 直接、可以喷人、”老登不是你亲戚”、拒绝模糊表述

AWS 云计算:全球第一的光环下,藏着怎样的真相?

AWS 是全球云计算市场占有率第一的厂商,这一地位已持续十余年。但”第一”是否等于”最好”?当我们抛开品牌光环,从架构设计、工程实践、性能数据、价格四个维度进行实测和分析后,得出的结论可能会颠覆很多人的认知。

本文所有结论均基于一手测试数据和抓包分析,不做任何主观外推。


一、设计理念:高可用的代价,用户买单

1.1 强制跨可用区:每次写入都要跨机房

AWS 的 RDS MySQL 默认部署模式是 Multi-AZ(多可用区),主备实例强制分布在不同的可用区。这一设计的出发点是高可用——单个机房故障时可以自动切换。但代价是什么?

每一次写操作,至少需要跨可用区至少 1 次:

  1. 应用写入主库 → EBS 通过网络同 AZ落盘
  2. 半同步复制 → 跨 AZ 将 binlog 发送到备库
  3. 备库确认收到 → 跨 AZ 返回 ACK

实测 AWS 可用区间 RTT 约 0.75ms 。这意味着仅网络延迟这一项,每次写操作就要额外付出 0.75ms 的开销,这在数据库上是无法忍受的慢慢慢!

以上是理论计算,我们来看一下实际业务体感:

  • AWS 上一次最简单的 INSERT:3.32ms(业务实测)
  • 同样的业务在 IDC 物理机:微秒级(0.x ms)

差距不是百分之几十,而是 数倍到一个数量级 。

1.2 对比:阿里云的灵活选择

阿里云 RDS 提供集群模式,允许将 2 个节点部署在同一可用区,在对延迟极度敏感的场景下实现接近 IDC 的性能。用户可以根据自身业务特点在”极致高可用”和”极致低延迟”之间做选择。

AWS 和华为云目前不提供这种灵活性,用户被强制接受跨 AZ 的延迟开销。

1.3 云盘延迟:贵不等于快

AWS 的 EBS 云盘走网络存储,延迟远高于本地盘。实测数据(fio 4K 随机读写,iodepth=1):

云盘类型 读延迟 写延迟
AWS io2(最贵) 393 us 306 us
AWS io1 588 us 868 us
AWS gp3 686 us 994 us

gp3 写延迟接近 1ms ,而阿里云 ESSD 在同等场景下可以做到 0.1~0.2ms 级别。AWS 最高档的 io2 写延迟(306us)仍然是阿里云高性能云盘的 2-3 倍 。

对于数据库这种对 IO 延迟极度敏感的负载,这意味着每一个 commit 都在额外等待。


二、工程实践:350 秒连接静默丢弃事件

如果说设计理念的问题还可以归结为”理念之争”,那么以下这个事件则暴露了 AWS 在工程实践和事故响应上的严重问题。

2.1 问题现象

业务迁移到 AWS 第 8 代实例(M8/C8/R8,Nitrov6 架构)后,Java 服务每隔 20~30 分钟出现批量连接超时:

1
Connection is not available; request timed out after 5006ms

网络延迟稳定在 ~8ms,0% 丢包,MySQL 健康。

2.2 根因:ENI 连接跟踪超时从 5 天骤降至 350 秒

通过 80 分钟、84595 个包的系统性抓包分析,定位到根因:

AWS 第 8 代实例的 ENI(弹性网卡)安全组连接跟踪,将 TCP Established 默认超时从 432000 秒(5 天)悄然改为 350 秒。

实例代次 Nitro 版本 TCP Established 默认超时
第 7 代及以下 Nitrov5 及以下 432000s(5 天)
第 8 代(M8/C8/R8) Nitrov6 350s

这是一个 1234 倍的缩减 ,且行为极为恶劣——超时后 ENI 静默丢弃数据包,不发送 RST,不通知任何一方。抓包中 84595 个包 0 个 RST 。

客户端和服务端都以为对方还在,TCP 连接变成”僵尸”——直到下次使用时才发现已死,此时应用只能等待重传超时(数十秒到数分钟),表现为”突然卡住然后超时”。

2.3 AWS 的事故复盘令人失望

这一事件中 AWS 的表现:

  1. 文档滞后:用户 4 月初碰到问题,4 月 7 日定位到中间设备释放连接,4 月 15 日还在抓包验证。而 AWS 直到 4 月 11 日才在文档中加入警告段(通过 Wayback Machine 快照对比确认)

  2. 变更未通知:从 432000s 改到 350s 这种破坏性变更,C8gn GA 公告(2025-06)中未提及超时变更。用户升级实例后莫名遇到连接问题,排查成本极高

  3. 比 NAT Gateway 更”哑”:

    • NAT Gateway / NLB 超时后至少一侧会收到 RST,应用能感知”对端断了”
    • ENI conntrack 超时:双侧都收不到 RST ,包被静默丢弃,应用只能靠 OS 重传超时来发现
  4. 复盘质量:AWS 官方的事件复盘未能清晰阐述根因,定位路径模糊

2.4 “350 秒”——AWS 的系统性问题

350 秒这个数字在 AWS 生态中反复出现:

组件 空闲超时 超时后行为
NAT Gateway 350s(固定) 发 RST
NLB(2024-09 前) 350s(固定) 发 RST
GWLB 350s 发 RST
ENI Conntrack(Nitrov6) 350s(默认) 静默丢弃

社区早在 2021 年就有人踩坑(Paramount Tech Blog),2022 年 DBA 博客记录了 JDBC 挂起问题,2023 年 urllib3 专门开了 Issue。这不是新问题,但 AWS 在 ENI 层面重蹈覆辙,且行为更恶劣(不发 RST)。


三、性能数据:Sysbench 实测全面落后

以下数据来自 10 个环境的标准化 Sysbench 测试,使用 16 表 x 1000 万行(约 50GB 数据),MySQL Buffer Pool 16GB,故意制造 IO 压力以考验真实磁盘性能。

3.1 只写场景(oltp_write_only)—— 单线程 QPS

这是最能体现”每次写操作延迟”的场景:

环境 1 线程 QPS 对比 IDC
IDC(物理机) 19,282 基准
IDC(trx1) 15,367 80%
阿里云 12,484 65%
阿里云(trx1+repl) 5,832 30%
AWS io2 8,881 46%
AWS io2(trx1) 3,575 19%
AWS gp3 1,689 9%

AWS gp3 单线程写入性能仅为 IDC 的 9%,仅为阿里云的 14%。 即使用最贵的 io2 云盘(价格是 gp3 的数倍),开启 trx1 后也只有 IDC 的 19%。

3.2 读写混合场景(oltp_read_write)—— 64 线程 QPS

环境 64 线程 QPS 对比阿里云
阿里云 83,569 基准
IDC 69,255 83%
AWS io2 51,002 61%
AWS gp3 64,869 78%

3.3 点查询场景(oltp_point_select)—— 64 线程 QPS

环境 64 线程 QPS 对比阿里云
阿里云 328,098 基准
IDC 299,555 91%
AWS io2 157,480 48%
AWS gp3 228,321 70%

AWS io2 在纯读场景下也只有阿里云的 48% ,令人诧异。

3.4 延迟对比(95 分位,单线程)

场景 IDC 阿里云 AWS io2 AWS gp3
点查询 0.04ms 0.07ms 0.09ms 0.67ms
只写 0.52ms 0.99ms 1.61ms 5.99ms
读写混合 2.81ms 3.30ms 3.89ms 15.00ms

AWS gp3 的只写延迟是 IDC 的 11.5 倍,是阿里云的 6 倍。

3.5 小结

即便使用 AWS 最贵的 io2 云盘(2T 云盘价格是 8C32G 机器的 8 倍),性能仍然大幅落后于阿里云使用普通云盘的配置。云盘延迟是 AWS 数据库性能的致命瓶颈。


四、价格:花更多的钱,买更差的性能

4.1 AWS RDS MySQL 成本

以 16C64G、GP3 2TB 20000 IOPS、3 节点(1 主 1 Multi-AZ 备 1 只读副本)为例:

Intel(db.m5d.4xlarge):

  • 计算:¥204,964/年(折后)
  • 存储(GP3 2TB x3):¥83,589/年(折后)
  • 监控(CloudWatch):¥25,713/年(折后)
  • 合计:约 ¥314,266/年

ARM(db.m6gd.4xlarge):

  • 计算:¥183,718/年(折后)
  • 存储:¥83,589/年(折后)
  • 合计:约 ¥267,307/年(不含监控)

最新一代 Intel(m7i.4xlarge,ap-southeast-1):价格更高。

4.2 性价比对比

维度 AWS(io2,最贵) AWS(gp3) 阿里云
只写 64 线程 QPS 79,754 43,519 110,923
读写混合 64 线程 QPS 51,002 64,869 83,569
云盘写延迟(iodepth=1) 306 us 994 us ~100-200 us
价格档位 极高 高 中

AWS 用最贵的云盘(io2),花了最多的钱,性能仍然不如阿里云用普通云盘。

io2 的 2T 云盘年费约为同规格机器的 8 倍——付出如此高昂的代价,换来的却是垫底的性能表现。

4.3 隐性成本

除了直接的资源费用,AWS 还有大量隐性成本:

  • 排障成本:350 秒静默丢连接这种问题,排查周期以周计,需要系统性抓包分析
  • 架构妥协成本:被迫跨 AZ 部署,无法选择同 AZ 低延迟模式
  • 升级风险成本:实例升代时默认行为发生破坏性变更,无事先通知
  • 学习曲线成本:需要深入了解 ENI 连接跟踪、NAT Gateway 固定超时等独有”坑点”

五、RDS MySQL 小版本升级维护需要重启两次

正常工程师脑回路的升级流程:Slave 升级到新版本,HA切换,业务闪断一次立即恢复正常,然后升级集群其它节点,完毕。

但AWS RDS MySQL 小版本升级的时候Master要重启2次,是的他们的升级逻辑就是这么干的导致我们业务2次跌0,很难想象这是全球最牛逼的云服务厂商干出来的事情,关键还不改 最可气的是他们认为这不是bug,只是by design,照这个歪理就没有bug,都是设计好了的

用户在这里最无助的就是他们不认为是bug,而且绝对不会去改

六、EMR 默认 JDBC 驱动兼容性缺陷:用了开源不测试,出了问题让客户自己换 jar

6.1 问题现象

EMR 集群(Hive 3.1.3)执行 CREATE TABLE 报错:

1
2
MetaException: Table "partition_keys" has been specified with a primary-key
to include column "TBL_ID" but this column is not found in the table.

Metastore 后端是 RDS MySQL 8.0,设置了 lower_case_table_names=1(AWS RDS 支持的合法配置)。

6.2 根因

EMR 默认打包的 JDBC 驱动是 MariaDB Connector/J 2.7.2,而非 MySQL 官方驱动。该驱动的 DatabaseMetaData.getColumns() 方法在连接 MySQL 8.0 + lower_case_table_names=1 时存在 bug:

  • MySQL 8.0 在 lower_case_table_names=1 下,数据字典中所有标识符以小写存储
  • MariaDB Connector 查询 information_schema 时,不对表名做大小写归一化,返回的列名全部是小写(tbl_id)
  • Hive Metastore 使用的 DataNucleus ORM 内部以大写定义主键列名(TBL_ID),做大小写敏感比较 → 匹配失败

MySQL 官方 Connector/J 很早就有 normalizeIdentifierCase() 方法处理此场景,替换为 MySQL Connector/J 8.0.33 后问题消失。

6.3 为什么 EMR 用 MariaDB Connector 而不是 MySQL 官方驱动

这是许可证原因,不是技术原因:

  • Oracle MySQL Connector/J 是 GPL v2(强 copyleft),商业产品分发时无法满足条款
  • Oracle 的 FOSS Exception 要求整体作品为自由软件,EMR 不适用
  • Apache 基金会将 GPL 列为 Category X 禁用许可,Hive/Spark 等上游项目本身就不能打包它
  • MariaDB Connector/J 是 LGPL 2.1(弱 copyleft),允许商业分发,协议兼容,能正常连接 MySQL

法律上没问题。但工程责任上呢?

6.4 AWS 的工程责任缺失

选择了 MariaDB Connector 作为默认驱动,连接的后端是 MySQL 8.0,lower_case_table_names=1 又是 MySQL Server 支持的合法参数组合——这条数据通路是 EMR 最核心的路径之一(Hive Metastore 每次建表、查表都走这里)。但 AWS:

  1. 没有充分集成测试:lower_case_table_names=1 + MySQL 8.0 + MariaDB Connector 的组合不是什么边缘场景,是 Hive Metastore 的核心路径。AWS 自己的 RDS 文档还专门说明如何设置此参数,结果自家 EMR 的默认驱动不兼容自家 RDS 的合法配置
  2. 没有回馈上游:这个 bug 在 MariaDB Connector 中存在多年,AWS 作为最大的间接用户之一,从未提交过 patch 或 issue
  3. 没有文档提示:EMR 文档中不存在任何 Known Issues 警告此兼容性问题
  4. 修复方案甩给客户:官方答复是”可通过 bootstrap action 自行替换 jar”——把本应是产品质量保证的工作,转嫁为客户的排障成本

6.5 这不是个案,是模式

我们已经向 MariaDB 社区提交了 bug report(CONJ-1344),但这件事本质上暴露的是 AWS 对开源组件的态度:

“我用 LGPL 不用付费也不用回馈,出了问题客户自己换 jar。”

这在法律上没毛病,但在工程责任上是甩锅。一个年收入百亿美元级的云产品,连核心数据通路的驱动兼容性都不做充分验证——不测试自家 RDS 参数和自家 EMR 驱动的组合——确实说不过去。

这和前面的”350 秒超时不通知”、”小版本升级重启两次 by design”如出一辙:AWS 追求的是”能跑起来”而非”跑得对”,出了问题不认 bug 只认 design,修复靠客户自助。全球第一的产品,三流的工程责任感。


其它

  • AWS 同一个Region下跨AZ流量收费的,0.02美金每GB(双向收费加起来)——相对应的阿里云、华为云这部分流量均免费
  • 强制升级但不退费——这个特别奇葩,买了一年的优惠套餐打折,结果半年后AWS强制RDS MySQL大版本从8.0升级到8.4,不用了也不行,要继续收费,如果是客户的原因继续收费是有道理的,但是AWS强制升级(相当于合同强制变更),但不退钱就是抢劫了

七、结论:惯性认知 vs 客观事实

AWS 能成为全球第一,有其历史原因:起步最早(2006 年)、生态最完善、全球覆盖最广。但”市场占有率第一”不等于”技术最优”,更不等于”性价比最高”。

从本文的实测数据来看:

维度 表现
设计理念 强制跨 AZ,牺牲延迟换高可用,不给用户选择权
工程实践 350s 超时静默丢包,变更不通知,复盘不透明
开源责任 用 LGPL 组件不测试不回馈,驱动兼容性问题甩给客户自行替换
性能 全场景 Sysbench 垫底,gp3 只写仅为 IDC 的 9%
价格 同等配置显著高于竞品,io2 价格是机器的 8 倍
性价比 花最多的钱,得到最差的性能

很多企业选择 AWS 的原因是”大家都在用””全球第一应该不会错”——这是典型的幸存者偏差和品牌惯性。当我们真正用数据说话时,会发现这个”全球第一”的光环,更多是依靠先发优势和生态锁定维持的,而非技术和性价比的领先。

对于数据库这类对延迟和 IO 性能极度敏感的工作负载,在有选择的情况下,AWS 恐怕是最不应该选的那一个。

当然站在 AWS 立场有一个必杀技:AWS 的设计理念就是……


注:本文所有性能数据均来自实际测试环境,测试工具为 sysbench,测试代码开源。网络分析基于 84595 个包的系统性抓包。价格数据来自官方控制台和报价器。文档变更时间线通过 Wayback Machine 快照验证。

0%