为什么你的连接不均衡了?——一次 LVS + Redis 的复现与根因定位
为什么你的连接不均衡了?
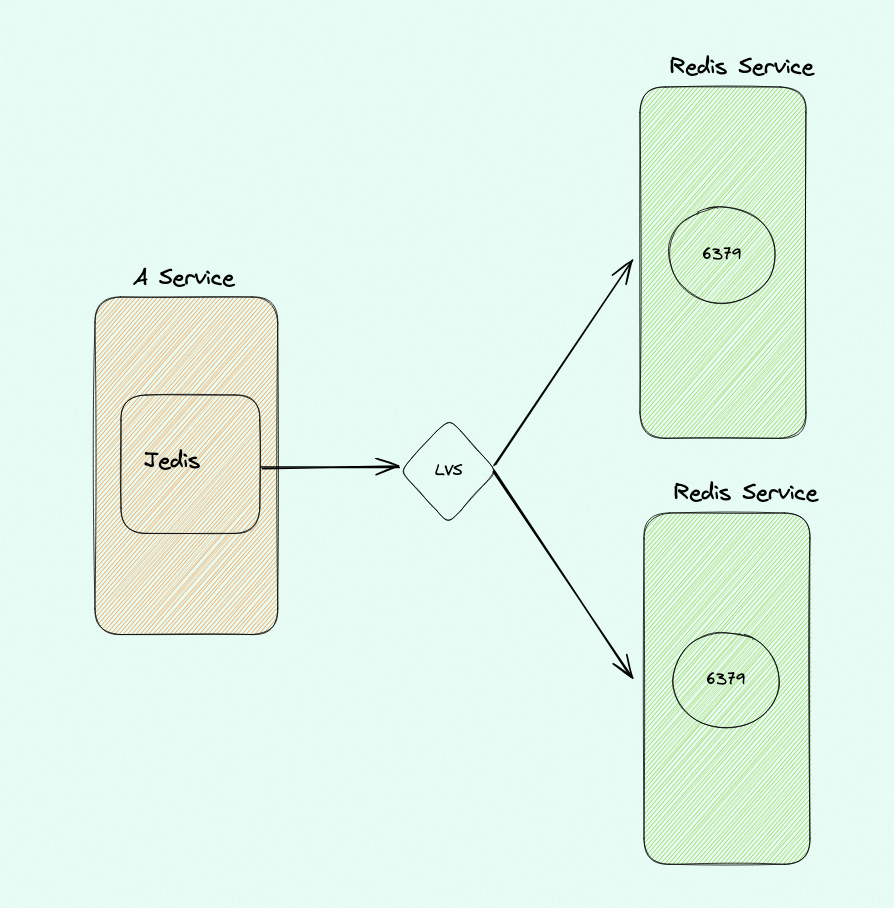
两个 Redis 挂在 LVS 后面,客户端用 Jedis 连接池访问,一切正常。直到某天其中一个 Redis 的 CPU 被抢占、开始变慢,你会发现流量开始往变慢的那个节点上堆——它越慢,接到的请求越多。
这个现象在云上大规模服务里非常典型:负载均衡背后两个节点,一个 CPU 90%、另一个 5%。
监控上连接是均衡的,IPVS 的连接数也是 1:1,但 CPU 就是不平。客户反复追问,运维查遍 LVS 配置、
健康检查、权重全部正常,最后往往不了了之。
这篇文章用一套完整的实验把现象复现出来,然后回到 commons-pool 的源码里找原因。
一、现象
场景是这样的:
- 两个 Redis 挂在 LVS(IPVS,RR 调度,NAT 模式)后面
- 业务客户端用 Jedis,连接池
maxTotal=200、maxIdle=100、minIdle=100 - 业务高峰时连接池打满到 200,低谷回落到 100
- 每个请求就是取一个连接、发一条 GET、把连接还回去
在两侧节点性能一致时,200 条连接被 IPVS 均分,两个节点各 100 条,一切平衡。
现在让其中一个节点变慢(CPU 被抢占、降频、磁盘 IO 阻塞都行):
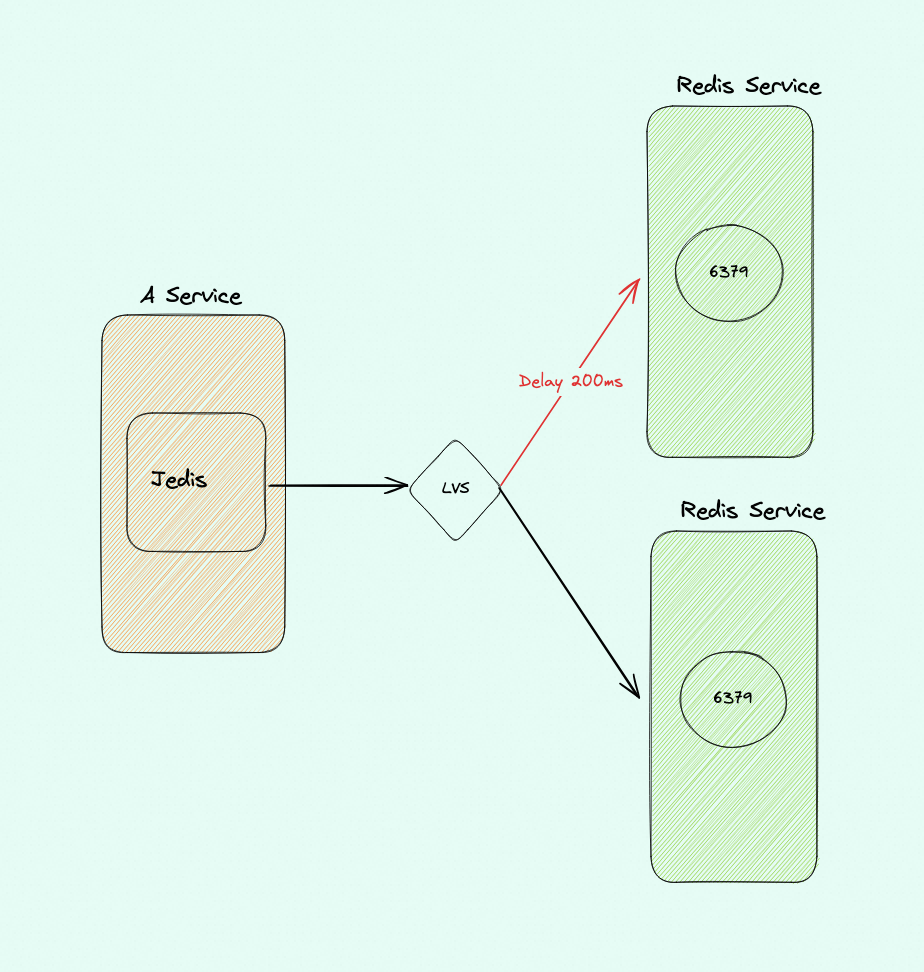
慢节点上的连接会越来越多,它处理的请求也越来越多。 恶性循环:
1 | 慢 → 连接归还晚 → 在连接池里排到"下次优先被取"的位置 |
注意这里要区分两个指标,本文的实验会把它们分别测出来:
| 指标 | 含义 | 谁决定 |
|---|---|---|
| 连接数 | 某时刻连到该节点的 TCP 连接条数 | 连接的创建与销毁时机 |
| 请求量 | 该节点累计处理多少条命令 | 池里连接的借用顺序 |
二、重现步骤
测试机:Rocky Linux 8.10,8 核,内核对 4.18。用 network namespace 把客户端和两个 Redis 隔开,保证客户端只能走 VIP。
1 | ns_client (<client>) |
关键点:客户端到两个后端的直连用 iptables DROP 掉,只留 VIP 这一条路,避免”绕过 LVS”污染实验。
1 | # 1. 两个独立的 Redis(各在自己的 netns 里) |
客户端用 Jedis 3.9.0(底层 commons-pool2 2.11.1),参数照抄原文:
1 | JedisPoolConfig config = new JedisPoolConfig(); |
两个容易被忽略的实验条件,缺了它们现象不会出现:
- 连接有生存期边界 — 池会主动淘汰空闲连接再补建。如果连接永不重建,IPVS 首次 RR 分配后就固定了,永远不会倾斜。
- 流量有高峰低谷 — 高峰打满池、低谷回落到
minIdle。池必须发生”取空—补充”的循环,”谁最后归还”才会影响”谁被留下”。
另外,制造慢的方式必须是确定性慢——每个请求都慢(CPU 抢占、网络延迟)。如果只是偶尔一条慢查询,长期平均下来会被抹平,看不出问题。
三、实测数据
共用 5 组实验,每组 300 秒,每秒采样一次。
实验一:连接数倾斜(驱逐生效)
持续打流,峰值 200 并发、低谷 100 并发各 20 秒交替。基线在无延迟的情况下本应 1.00,
实测 0.85 是采样窗口内正常的波动幅度,可以当作噪声水平参考。
| 实验 | 池策略 | 慢节点 | r1 连接 均值/峰值 | r2 连接 均值/峰值 | r1/r2 |
|---|---|---|---|---|---|
| 基线 | LIFO | 无 | 70.8 / 103 | 83.3 / 122 | 0.85 |
| 实验 | LIFO | CPU 抢占 | 102.8 / 149 | 63.4 / 104 | 1.62 |
| 实验 | LIFO | CPU 抢占 | 107.7 / 146 | 59.9 / 96 | 1.80 |
| 对照 | FIFO | CPU 抢占 | 75.9 / 116 | 85.3 / 140 | 0.89 |
| 对照 | FIFO | CPU 抢占 | 82.6 / 146 | 79.0 / 135 | 1.05 |
同一份 CPU 抢占,LIFO 下慢节点连接堆积(1.62、1.80),FIFO 下完全消失(0.89、1.05,和基线同一水平)。
而几次实验里两个节点的 QPS 差一直都在(慢节点约 31500,快节点约 44500),说明”节点确实慢了”,
只是 FIFO 下连接分布没被带偏。
实验二:请求量倾斜(连接数恒定)
把池的驱逐关掉(连接永不重建,池里始终是预热时建立的那 200 条,100 在用、100 空闲),
100 并发(50% 水位),用 Redis 的 total_commands_processed 直接数两个节点各处理了多少条命令。
| 实验 | 池策略 | 慢节点 | r1 处理命令数 | r2 处理命令数 | r1/r2 |
|---|---|---|---|---|---|
| 基线 | LIFO | 无(0.1ms) | 2,506,284 | 2,592,694 | 0.97 |
| 对照 | LIFO | 轻抢占(延迟未变) | 3,797,351 | 3,751,655 | 1.01 |
| 实验 | LIFO | 间歇变慢(avg 4ms / max 14ms) | 3,140,216 | 2,146,807 | 1.46 |
| 对照 | FIFO | 同上 | 724,496 | 1,010,436 | 0.72 |
| 实验复测 | LIFO | 同上 | 2,030,441 | 1,527,893 | 1.33 |
| 实验复测 | LIFO | 同上 | 2,075,231 | 1,432,625 | 1.45 |
| 对照复测 | FIFO | 同上 | 480,769 | 669,638 | 0.72 |
“轻抢占”那行是个重要的反例:CPU 抢占了,但延迟没有实质性变化(0.11ms vs 0.12ms),
请求量比值就还是 1.01。只有”确实变慢”才会触发倾斜,这一条排除了”抢占动作本身”的干扰。
“间歇变慢”是指 redis 绑定的核被死循环抢占:redis-cli --latency 实测 avg 4.01ms、max 14ms、
快节点 avg 0.11ms。大部分请求正常,少数请求被抢占拖慢——这正是生产环境 CPU 被其他进程
间歇抢占的真实形态,不是人为给每个请求加固定延迟。
这组数据最关键的是 LIFO 与 FIFO 的对立:
- LIFO:慢节点处理了多出 33%~46% 的请求,而连接总数完全均衡
- FIFO:慢节点反而少处理 28%——这是工程师期望出现的
关于可比性:不同轮的绝对吞吐不可直接横向比(CPU 抢占强度每轮略有差异,
LIFO 轮次的总吞吐明显高于 FIFO 轮次)。有意义的是同一轮内 r1 与 r2 的比值——
两个节点承受的是完全相同的一次故障注入,比值直接反映调度是否公平。
同样的 CPU 抢占、同样的连接总数,只改一个 setLifo(true/false),方向就反过来了。
需要强调”连接总数完全均衡”不是一句空话——这五组实验里,两侧的连接数在每一秒的采样中都是:
| 实验 | r1 连接数 均值/峰值 | r2 连接数 均值/峰值 | 请求量 r1/r2 |
|---|---|---|---|
| c_lifo | 100.1 / 102 | 100.0 / 102 | 1.33 |
| c_lifo2 | 99.9 / 102 | 99.8 / 102 | 1.45 |
| c_fifo | 100.3 / 102 | 101.0 / 102 | 0.72 |
| hog60_lifo | 100.2 / 101 | 100.1 / 101 | 1.46 |
| hog60_fifo | 99.7 / 101 | 101.0 / 101 | 0.72 |
连接数一模一样,处理的请求量差了 40%~50%。 这就是”看起来均衡、实际不均衡”的全部真相。
四、根因分析
看 commons-pool2 2.11.1 的源码,三行就能说清楚:
1 | // GenericObjectPool.borrowObject():296 —— 借连接,永远从队头取 |
而 DEFAULT_LIFO = true(BaseObjectPoolConfig.java:41),默认就是 LIFO。
于是:
1 | LIFO(默认) FIFO |
慢节点的连接处理久、归还晚。LIFO 把它放在队头,下一次 pollFirst() 第一个取走它——
它比均分多工作,于是更慢,归还更晚,又回队头。正反馈闭合。
FIFO 把它放在队尾,要等前面所有连接都轮过一遍才轮到它——它比均分少工作。
实测 FIFO 下慢节点请求量只有快节点的 0.72,正是这个”保护”效应。
为什么连接数也会倾斜
请求量倾斜之后,慢节点的连接长期处于”使用中”、几乎不空闲。commons-pool 的 evictor
(空闲连接驱逐线程,每 1 秒扫一次,销毁空闲超过 3 秒的连接)扫过来时,
快节点的空闲连接被销毁重建,慢节点的连接因为不空闲而幸存。
驱逐后补建的新连接由 IPVS 按 RR 均分,但幸存下来的存量连接已经在慢节点上越积越多。
这就是实验一里 1.62 / 1.80 的来源。关掉驱逐(实验二),连接数就不再倾斜,
但请求量倾斜依然存在——因为它是借用顺序造成的,与连接是否重建无关。
五、总结
这个问题不止于 Jedis 和 Redis
LIFO 是 Apache commons-pool 的默认行为(BaseObjectPoolConfig.DEFAULT_LIFO = true)。
所有用它做连接池的客户端都会中招:
- Jedis(
JedisPool直接基于 commons-pool2) - Lettuce(
lettuce-pool模块基于 commons-pool2) - commons-dbcp(各种 JDBC 连接池)
- 任何直接
new GenericObjectPool(...)的场景
判定条件只有三条,缺一不可:
- 取连接用 LIFO(栈)
- 后端节点存在确定性的快慢差异(每个请求都慢,不是偶发慢)
- 连接会被反复复用很多次(连接池场景天然满足)
只要三条同时成立,慢节点就会越吃越多,最后成为瓶颈,甚至被打挂。
在这个场景下,FIFO 对均衡明显优于 LIFO
| 请求量 r1/r2 | 连接数 r1/r2 | |
|---|---|---|
| LIFO(默认) | 1.33 ~ 1.46(慢节点更忙) | 1.62 ~ 1.80(越堆越多) |
| FIFO | 0.72(慢节点被保护) | 0.89 ~ 1.05(保持均衡) |
依据是上面的实测:同样的故障注入,LIFO 让慢节点多干三到四成的活,FIFO 让它少干三成。
FIFO 的逻辑也说得通——从队尾取,等于让连接”轮着用”,慢连接自然用得更少,
不会形成自我强化的正反馈。
代价与取舍
先澄清一个常见的误解:LIFO 和 FIFO 都不影响新建连接的频率。
连接什么时候建、什么时候销毁,是池自己决定的——只有 idleObjects 空了且 active < maxTotal 才新建,
只有空闲超时(evictor)或 maxIdle 溢出才销毁。这两件事跟”从队头还是队尾取”没有关系。
在 minIdle 稳定的池里,两种策略的建连次数基本一致。
commons-pool 默认 LIFO 的理由,源码 javadoc 写得很清楚:
Gets whether the pool has LIFO (last in, first out) behavior with respect to idle objects
- always returning the most recently used object from the pool
它带来的实际差别是取出来的连接有多”新”:
- LIFO:取出的总是刚用过的连接,TCP 是热的,几乎不可能已经被服务端或中间设备悄悄掐断
(防火墙/NAT 空闲超时、MySQLwait_timeout、Redistimeout) - FIFO:取出的可能是躺了很久的老连接。在
testOnBorrow=false(很多客户端默认如此)下,
这条连接可能早已失效,发过去才发现 broken pipe
这才是 LIFO 作为默认值的真实理由,也是切到 FIFO 要付的代价。所以 FIFO 适合配套两件事一起用:
testOnBorrow=true或至少testWhileIdle=true,把死连接挡在池外minEvictableIdleTimeMillis设得明显小于任何中间设备的空闲超时,让连接在被外部掐断前主动重建
一句话:LIFO 用”连接新鲜”回避死连接,FIFO 用”额外校验”换取负载均衡。
在有节点快慢差异的场景里,后者通常更值——因为死连接会立刻报错、能被发现,
而慢节点上的倾斜是静默的,往往要等 CPU 打到 90% 才被人注意到。
一句话
连接池默认是 LIFO 栈。栈顶那个”还回来最晚”的连接,就是最慢节点上的连接——
它因此被用得最多,变得更慢。这是连接池层面的结构性缺陷,不是 LVS 的锅,也不是 Redis 的锅。